Chip AI Presisi Rendah Baru IBM Capai 25,6 TFLOPS Pelatihan dan 102,4 TOPS Inferensi
Pada ISSCC 2024, IBM Research memperkenalkan prototipe 7 nm yang merupakan tahun-tahun kerja pada pelatihan dan inferensi AI presisi rendah. Chip ini menyediakan pelatihan 16-bit dan 8-bit, serta inferensi 4-bit dan 2-bit—di bawah norma industri pelatihan 32-bit / inferensi 8-bit.
Menurunkan presisi numerik memotong kebutuhan komputasi dan daya, tetapi IBM juga memperkenalkan beberapa optimasi arsitektur yang meningkatkan efisiensi lebih lanjut. Tantangan utamanya adalah mengurangi presisi tanpa merusak akurasi—suatu masalah yang IBM tangani dari tingkat algoritmik selama bertahun-tahun.
AI Hardware Center IBM, yang diluncurkan pada 2019, bertujuan meningkatkan performa komputasi AI sebesar 2,5× setiap tahun, menargetkan peningkatan 1.000× dalam FLOPS/W pada 2029. Tujuan ambisius ini didorong oleh pertumbuhan meletup model AI—terutama sistem NLP triliunan parameter—dan jejak karbon yang semakin besar dari pelatihan mereka.
Pada prototipe, chip 4-core mencapai 25,6 TFLOPS untuk pelatihan 8-bit, sambil menyampaikan 102,4 TOPS untuk inferensi integer 4-bit (keduanya diukur pada 1,6 GHz dan 0,75 V). Menurunkan jam ke 1 GHz dan tegangan ke 0,55 V meningkatkan efisiensi daya menjadi 3,5 TFLOPS/W (FP8) atau 16,5 TOPS/W (INT4).
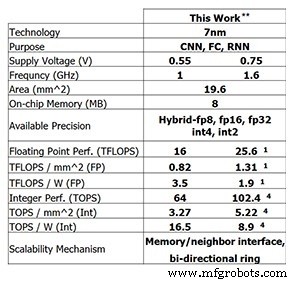
Performa chip uji IBM Research (Gambar: IBM Research) **Performa yang dilaporkan pada 0% sparsity. (1) FP8. (4) INT4.
Pelatihan Presisi Rendah
Performa ini dibangun berdasarkan bertahun-tahun kerja algoritmik pada teknik pelatihan dan inferensi presisi rendah. Chip ini adalah yang pertama mendukung format FP8 hibrid IBM, yang diperkenalkan pada NeurIPS 2019, yang memungkinkan pelatihan 8-bit sambil membagi dua komputasi pelatihan 16-bit tanpa mengorbankan hasil.
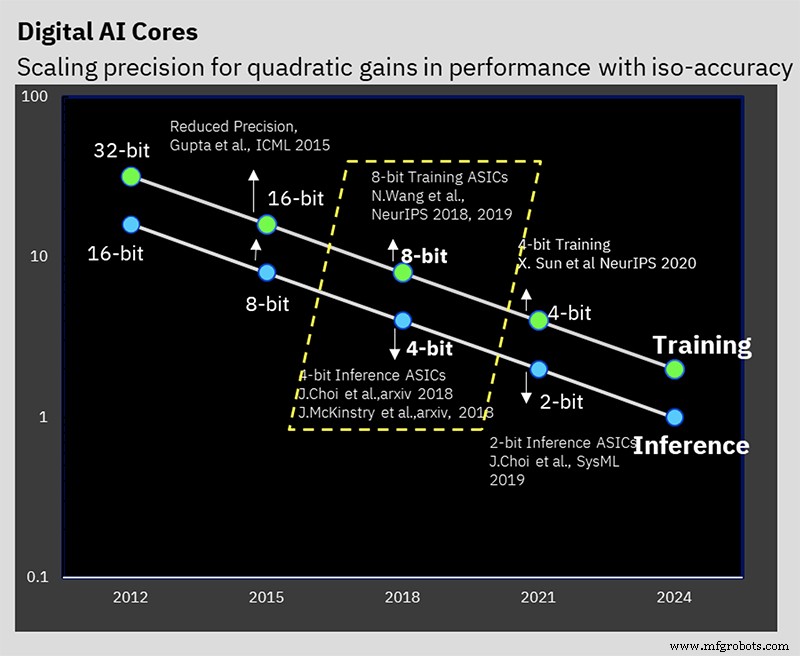
IBM Research telah bekerja pada pemecahan masalah mempertahankan akurasi sambil mengurangi presisi (Gambar: IBM)
“Pelatihan presisi rendah adalah tantangan, tetapi pelatihan 8-bit dapat dicapai dengan format angka yang tepat,” kata Kailash Gopalakrishnan, IBM Fellow dan senior manager untuk arsitektur akselerator dan pembelajaran mesin. “Format numerik yang tepat, diterapkan pada tensor yang benar, adalah kritis.”
FP8 hibrid menggabungkan dua format: satu untuk bobot dan aktivasi dalam lus maju, dan yang lain untuk gradien dalam lus mundur. Pelatihan memerlukan kedua lus, sedangkan inferensi hanya menggunakan format maju.
“Kami menemukan bahwa tensor maju membutuhkan fidelitas yang lebih tinggi—lebih presisi dalam mantissa—sedangkan gradien membutuhkan rentang dinamis yang lebih luas dengan eksponen yang lebih besar. Trade-off ini menyebabkan pembagian 1-4-3 (sign-exponent-mantissa) untuk maju dan eksponen 5-bit untuk mundur, memberikan rentang dinamis 232. Hardware kami sekarang mendukung kedua varian.”
Akumulasi Hierarkis
Teknik “akumulasi hierarkis” IBM mengurangi presisi selama akumulasi bersama bobot dan aktivasi. Pelatihan FP16 tradisional mengakumulasi dalam aritmatika 32-bit untuk mempertahankan akurasi, tetapi skema 8-bit mengakumulasi dalam FP16. Dengan mengelompokkan akumulasi panjang menjadi potongan yang lebih kecil dan menjumlahkannya, chip meminimalkan kesalahan pembulatan tanpa mengorbankan manfaat presisi lebih rendah.
“Menambahkan ribuan angka secara berurutan dapat menurunkan presisi,” jelas Gopalakrishnan. “Pengelompokan akumulasi menjaga jumlah tetap akurat sambil menjaga hardware tetap ringan.”
Inferensi Presisi Rendah
Sementara sebagian besar mesin inferensi menggunakan INT8, IBM menunjukkan bahwa aritmatika integer 4-bit dapat mencocokkan akurasi state-of-the-art. Setelah kuantisasi, langkah pelatihan sadar kuantisasi mengurangi kehilangan akurasi menjadi kurang dari 0,5 %, yang dapat diterima untuk banyak aplikasi.
Cincin On-Chip
Chip ini mengintegrasikan jaringan-on-chip yang dioptimalkan untuk deep learning, memungkinkan core untuk multicast data secara efisien. Ini mengurangi lalu lintas memori luar-chip dan kebutuhan bandwidth.
“Kami memisahkan frekvensi operasi cincin dari core, yang memungkinkan optimasi independensi dan kecepatan core yang lebih tinggi tanpa latensi kabel panjang cincin,” kata Ankur Agrawal, staf peneliti dalam pembelajaran mesin dan arsitektur akselerator.
Manajemen Daya
IBM memperkenalkan skema penskalaan frekvensi yang menjaga chip tetap di dekat envelop dayanya selama beban kerja. Dengan menetapkan tegangan dan frekvensi awal secara agresif, chip menjaga performa tinggi selama fase komputasi berat dan menyesuaikan dengan permintaan yang lebih rendah tanpa perubahan tegangan yang mahal.
“Beban kerja deep learning memiliki puncak dan lembah daya yang berbeda,” kata Agrawal. “Strategi kami menjaga konsumsi daya tetap stabil, mengubah lembah menjadi keuntungan performa.”
Chip Uji
Desain 4-core menyeimbangkan kompleksitas konektivitas dengan ukuran core, menawarkan arsitektur yang dapat diskalakan. IBM memperkirakan chip 1-2 core untuk perangkat edge dan chip 32-64 core untuk penerapan data-center, semuanya mampu FP16, FP8 hibrid, INT4, dan INT2.
“Berbagai domain aplikasi membutuhkan trade-off presisi dan daya yang berbeda,” kata Gopalakrishnan. “Satu format serbaguna kami memungkinkan kami menargetkan setiap kasus penggunaan tanpa mengorbankan efisiensi.”
Melengkapi hardware, IBM Research merilis tumpukan kompiler “Deep Tools,” mencapai utilizasi 60–90 % pada chip.
Menurut wawancara sebelumnya, chip AI presisi rendah berdasarkan arsitektur ini seharusnya mencapai pasar dalam dua tahun.
>> Artikel ini awalnya dipubliker di situs kami yang serupa, EE Times.
Konten Terkait:
- Chip AI mempertahankan akurasi dengan reduksi model
- Pelatihan model AI di edge
- Balapan untuk AI di edge
- Edge AI menantang teknologi memori
- Kelompok teknik berusaha mendorong 1mW AI ke edge
- Aplikasi jaringan syaraf tiruan untuk tugas skala kecil
- Penelitian IC AI menjelajahi arsitektur alternatif
Untuk lebih banyak Embedded, langganan newsletter email harian Embedded.



