Chip AI Groq TSP Kini Memacu Beban Kerja Cloud melalui Nimbix
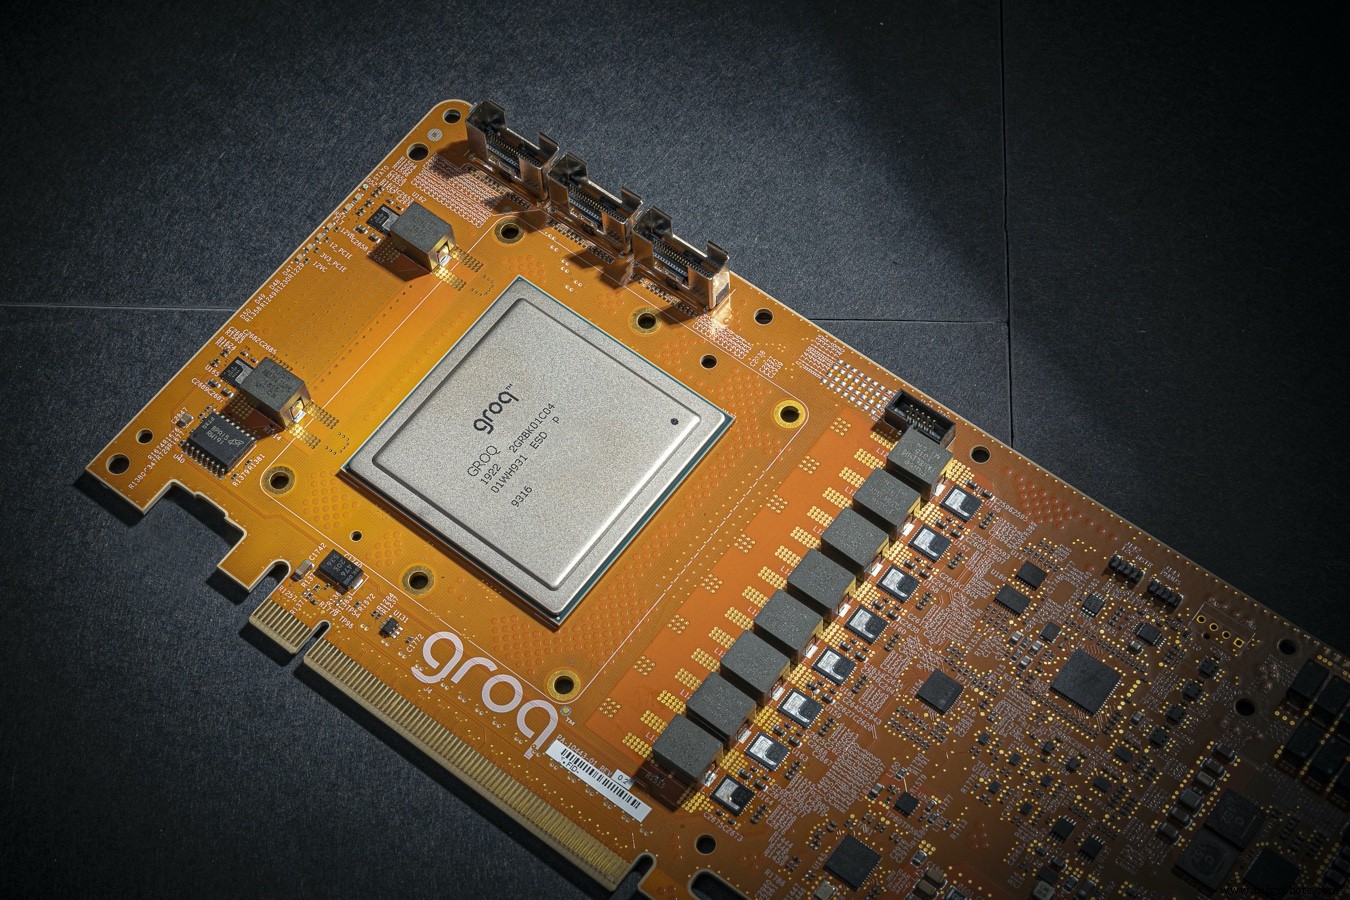
Silicon tensor streaming processor (TSP) Groq telah ditambahkan ke cloud, memungkinkan pelanggan untuk mempercepat beban kerja AI on demand. Nimbix kini menawarkan percepatan machine learning berbasis TSP secara eksklusif untuk pelanggan terpilih.
Dalam arena kompetitif silikon AI data-center, Groq berdiri di samping Graphcore sebagai satu-satunya startup dengan akselerator yang secara komersial tersedia dan terintegrasi ke dalam layanan cloud. Chip Graphcore sudah ditawarkan melalui Microsoft Azure.
"Arsitektur pemrosesan yang disederhanakan Groq unik, menyediakan performa deterministik yang tak pernah terjadi sebelumnya untuk beban kerja intensif komputasi, dan merupakan penambahan yang menarik untuk platform AI dan Deep Learning berbasis cloud kami," kata Steve Hebert, CEO Nimbix.
Groq adalah startup akselerator AI kedua yang membuat hardwarenya tersedia di cloud (Gambar: Groq)
Dirilis musim gugur lalu, chip TSP Groq memberikan 1.000 TOPS (1 peta operasi per detik) yang mengesankan. Dalam benchmark terbaru, chip mencapai 21.700 inferensi ResNet-50 v2 per detik—lebih dari dua kali lipat kecepatan sistem berbasis GPU kontemporer—menekankan statusnya sebagai salah satu prosesor jaringan saraf neural komersial tercepat.
"Hasil ResNet-50 ini adalah validasi bahwa arsitektur dan pendekatan unik Groq terhadap percepatan machine learning memberikan performa inferensi yang jauh lebih cepat dari pesaing kami," kata Jonathan Ross, pendiri dan CEO Groq. "Bukti dunia nyata ini, berdasarkan benchmark standar industri dan bukan simulasi atau emulasi hardware, mengonfirmasi peningkatan kinerja yang terukur untuk aplikasi machine learning dan kecerdasan buatan yang dimungkinkan oleh teknologi Groq."
Desain Groq mencapai paralelisme massal yang dibutuhkan untuk percepatan deep-learning tanpa overhead sinkronisasi yang khas dari CPU dan GPU. Dengan menyerahkan logika kontrol ke compiler—ciri khas strategi perangkat lunak-berdasar Groq—perusahaan memberikan performa yang sepenuhnya deterministik dan dapat diramalkan yang dapat diukur pada waktu kompilasi.
Keunggulan yang menonjol adalah bahwa peningkatan kinerja Groq tidak tergantung pada batching, taktik data-center umum yang memproses beberapa sampel secara bersamaan untuk meningkatkan throughput. Chip TSP mencapai performa puncak bahkan pada batch = 1, ideal untuk stream inferensi real-time. Sementara chip menawarkan keuntungan laten 2,5× dibandingkan GPU pada ukuran batch besar, keuntungan tersebut naik menjadi 17× pada batch = 1.