Membangun Sistem AI yang Kuat: Algoritma Anti-Kesalahan untuk Industri
Kegagalan pada kamera visi mesin, sensor yang tidak dikalibrasi, atau bayangan yang tidak terduga dapat menyebabkan kesalahan yang berpotensi berbiaya tinggi dan berbahaya dalam sistem AI industri. Namun, peneliti sedang mengembangkan algoritma anti-kesalahan serta langkah sederhana yang dapat diambil untuk mengurangi probabilitas kesalahan.
Kecerdasan buatan telah berkembang jauh di luar jaringan syaraf buatan perceptron dasar, namun kesalahan masih menjadi masalah. Image used courtesy of Pixabay
Aplikasi Industri untuk Kecerdasan Buatan
Ada banyak aplikasi industri untuk AI (kecerdasan buatan), seperti platform robotika, penanganan materi, kemasan, pemeliharaan mesin, perakitan, pemeriksaan, dan BAS (sistem otomasi bangunan). Contoh yang lebih spesifik termasuk teknologi drone dan swarm untuk pengurutan, perpindahan, dan pengiriman item atau deteksi anomali dalam proses produksi.
AI telah menjadi aspek krusial namun sering terlupakan dari otomasi industri yang bergantung pada visi mesin, lengan robot, sensing jarak jauh, dan kontrol proses.
Namun, alat AI bukanlah kotak hitam sederhana di mana data diberikan sebagai input dan diubah menjadi output yang akurat. Kadang-kadang outputnya salah, dan itu adalah sumber kekhawatiran.
Jenis-Jenis Kesalahan dalam Aplikasi Industri
Komputer melakukan apa yang diperintahkan padanya, jadi manusia adalah akar dari setiap kesalahan. Ini bisa menjadi kesalahan desain, kesalahan algoritma, kesalahan rekayasa, atau data buruk, tapi akan ada manusia di akarnya.
Ini juga berlaku untuk AI, termasuk AI industri. Kesalahan dalam AI industri dapat terbagi menjadi dua kategori: bias algoritma dan bias mesin.
Bias algoritma melibatkan kesalahan yang berulang dan sistemik. Kesalahan semacam itu dapat muncul dalam beberapa cara yang berbeda: kesalahan bawaan dalam logika algoritma, penggunaan yang tidak terduga dari output algoritma, atau masalah dengan data yang diberikan ke sistem AI.
Bias mesin terjadi ketika himpunan data yang terbatas digunakan untuk melatih sistem, yang mengarah pada output yang salah.
Pentingnya Menjaga Kesalahan AI Bajo Kontrol
Sebagai contoh bias algoritma, pertimbangkan sistem visi mesin yang didukung AI yang digunakan untuk sistem kontrol kualitas otomatis. Aplikasi semacam ini sangat bergantung pada pengukuran yang akurat yang disediakan sebagai data ke AI, yang menentukan apakah bagian tersebut berada dalam toleransi. Jika pengukuran yang tidak akurat diberikan ke AI, akan mengarah pada pelabelan bagian yang salah.
Algoritma di balik visi mesin AI dapat 100% benar, tapi data buruk berarti output buruk. Bagian yang dapat diterima dapat dibuang, sementara bagian kualitas buruk dapat dikirim ke pelanggan. Ini mengarah pada biaya dan downtime yang tidak perlu saat sumber masalah dilacak.
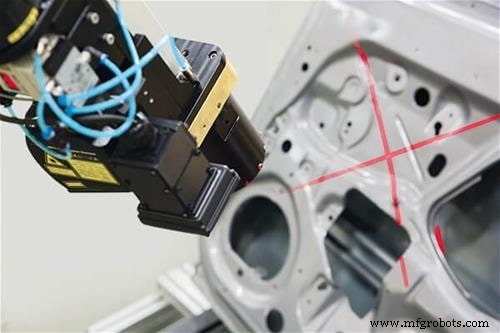
FANUC's iRVision 3DL menggunakan laser dan AI untuk memeriksa kondisi permukaan bagian. Image used courtesy of FANUC
Beberapa sistem AI yang memerlukan pelatihan sebelum digunakan di lingkungan atau aplikasi tertentu. Dalam kasus semacam itu, data pelatihan yang diberikan ke sistem sangat penting. Misalnya, jika sistem menerima pelatihan yang terbatas pada kondisi di area yang terang, akan ada masalah saat sistem harus beroperasi tanpa cahaya.
Anti-Kesalahan AI (Melatih AI)
Karena ada elemen manusia di balik AI dan pembelajaran mesin, ia tidak dapat anti-kesalahan. Namun, ada cara untuk meminimalkan kesalahan dalam sistem AI. Contohnya adalah CARRL (Certified Adversarial Robustness for Deep Reinforcement Learning), algoritma pembelajaran dalam yang dikembangkan di MIT yang bertujuan untuk membantu sistem otonom dengan mendorong tingkat skeptisisme terhadap data yang dipertimbangkan, seperti kebisingan dalam data dan upaya adversarial untuk menyesatkan sistem.
Carnegie Mellon juga telah bekerja pada algoritma AI untuk model pembelajaran dalam. Disebut RATT (Randomly Assign, Train and Track), pendekatan ini menggunakan data pelatihan yang tidak berlabel dan bising untuk menetapkan batas atas risiko kesalahan aktual. Batas atas ini kemudian dapat menentukan seberapa baik model AI menyesuaikan diri dengan data input baru. Selain itu, peneliti di Princeton telah mempelajari algoritma yang akan memungkinkan sistem AI untuk belajar secara efektif ketika kesalahan ada dalam data pelatihan.
Ada juga standar yang sedang dikembangkan yang akan mempengaruhi upaya anti-kesalahan. NIST (National Institute of Standards and Technology) aktif berkontribusi pada standar AI yang mencakup fokus pada evaluasi keandalan teknologi AI. NIST juga telah mengusulkan pendekatan untuk mengurangi risiko bias dalam sistem AI.
CISA Amerika Serikat (Cybersecurity and Infrastructure Security Agency) sudah memeriksa standar untuk penilaian algoritma AI dan pengumpulan data, seperti yang terungkap dalam panel tahun 2020 yang berjudul "Genius Machines." Upaya ini, bersama dengan NIST, menekankan akuntabilitas.
Menangani Kesalahan dalam Sistem AI
Sementara anti-kesalahan sistem AI yang menjadi tanggung jawab Anda mungkin tidak mungkin dilakukan karena elemen manusia yang terlibat, ada tentu cara untuk meminimalkan kemungkinan kesalahan.
Jika Anda mencurigai kesalahan datang dari sistem AI Anda, jangan langsung menyalahkan algoritma; malah, pelajari kesalahan untuk mencari pola. Misalnya, jika itu adalah robot pemotong bin otonom yang membuat kesalahan, lihat apakah ada sesuatu yang sama pada item yang diurutkan secara salah atau apakah ada perubahan dalam lingkungan robot (pencahayaan, bayangan, dll.) yang dapat mempengaruhi performanya. Kemungkinan juga ada masalah dengan lensa kamera kotak di bagian visi mesin sistem, seperti yang ditemukan dalam robot seluler otonom.
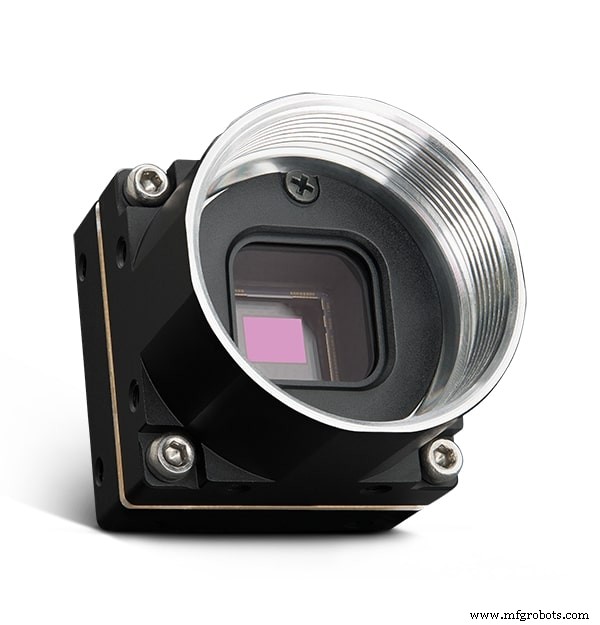
Banyak kamera visi mesin memiliki sistem AI bawaan, seperti FLIR Firefly DL, tetapi sistem ini dapat menghasilkan kesalahan jika tidak dijaga bersih dan dikonfigurasi dengan benar. Image used courtesy of FLIR
Sebuah aturan keras dalam pemrograman adalah input buruk akan selalu menghasilkan output buruk. Langkah pertama dalam meminimalkan kesalahan yang dihasilkan oleh sistem AI industri adalah untuk memastikan bahwa data-nya akurat sebanyak mungkin, dimulai dari sensor. Sensor yang menyediakan data input ke sistem AI harus dikalibrasi secara teratur.
Alat dalam sistem AI yang memungkinkan pengguna untuk menetapkan rentang yang dapat diterima untuk data harus diimplementasikan setelah mempertimbangkan rentang yang dapat diterima: terlalu ketat, dan AI tidak akan memberikan banyak nilai; terlalu longgar, dan ia menghasilkan terlalu banyak kesalahan. Dan ingat, nilai-nilai ini dapat disesuaikan.
Juga, seperti yang diindikasikan sebelumnya, jaga kamera tetap bersih. Sementara sistem visi mesin dirancang untuk kuat dalam berbagai kondisi lingkungan, itu tidak berarti mereka akan tetap berfungsi dengan baik saat visi terpengaruh oleh lensa kotak. Hal yang sama berlaku untuk sensor industri lainnya yang akurasinya dapat terpengaruh oleh pembentukan karat, paparan lingkungan korosif, masalah mekanis, atau penuaan.
AI digunakan secara luas di sektor industri untuk segala sesuatu mulai dari kontrol proses hingga inspeksi kualitas. Dan karena faktor manusia yang terlibat, sistem AI ini juga rentan terhadap kesalahan. Algoritma anti-kesalahan sedang dikembangkan, tetapi metode ini belum matang sepenuhnya, dan belum pernah diuji secara luas pada aplikasi industri. Dan sementara organisasi seperti NIST dan CISA sedang bekerja menuju standar anti-kesalahan, mereka masih dalam pengembangan. Namun, beberapa langkah sederhana dapat mengurangi probabilitas kesalahan dalam sistem AI Anda.



