Bagaimana Pemrosesan Sinyal Canggih Mengaktifkan Interaksi Asisten Suara yang Mulus
Speaker pintar dan perangkat dikontrol suara berkembang pesat, dengan asisten seperti Amazon Alexa dan Google Assistant semakin baik dalam memahami perintah lisan kami dengan setiap pembaruan.
Salah satu daya tarik terbesar dari antarmuka ini adalah sifatnya yang mudah—tidak ada kurva pembelajaran, hanya obrolan alami. Di balik pengalaman yang mulus ini terletak rantai langkah pemrosesan sinyal yang canggih yang mengubah audio mentah menjadi permintaan yang jelas dan dapat ditindaklanjuti.
Dalam artikel ini kami memeriksa arsitektur yang mendukung solusi kontrol suara, mengungkapkan lapisan hardware dan perangkat lunak yang tersembunyi yang menghidupkannya.
Aliran Sinyal dan Arsitektur
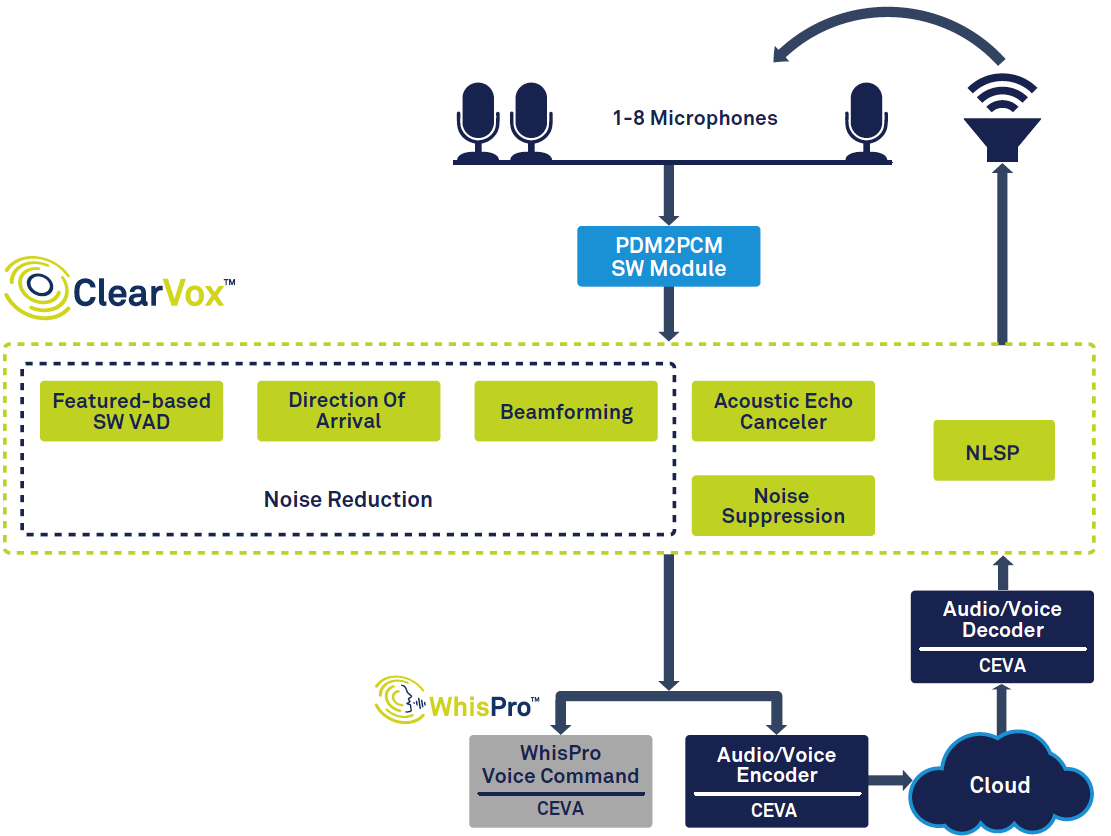
Meskipun spesifiknya bervariasi di antaraproduk, aliran dasarnya konsisten. Menggunakan speaker pintar seperti Amazon Echo sebagai contoh, subsistem utama diilustrasikan dalam Gambar 1.
klik untuk gambar lebih besar Gambar 1: Rantai sinyal untuk asisten suara, berdasarkan ClearVox dan WhisPro CEVA. (Sumber: CEVA)
Rantai dimulai dengan deteksi aktivitas suara (VAD), yang mengisolasi segmen yang diucapkan. Audio yang tertangkap di-digitalkan dan ditetapkan pada serangkaian algoritma front-end yang meningkatkan kejelasan dengan fokus pada arah kedatangan pengguna. Sinyal yang diproses kemudian diteruskan ke pemrosesan suara back-end, yang dapat berjalan sebagian di perangkat (edge) dan sebagian di cloud. Akhirnya, respons—teks atau suara—disintesis, didekode, dan dirender melalui jalur digital-to-analog speaker.
Berbagai kasus penggunaan memperkenalkan variasi. Misalnya, antarmuka suara di dalam kendaraan harus mengatasi kebisingan jalan, sementara wearable yang muncul menuntut daya ultra rendah dan biaya minimal.
Pemrosesan Sinyal Front-end
Setelah VAD dan digitalisasi, perangkat harus menekan suara yang tidak diinginkan. Pembatalan gema akustik (AEC) menghilangkan refleksi yang disebabkan oleh pemutaran perangkat itu sendiri, memungkinkan “barge-in” yang mulus bahkan saat musik diputar. Penekanan kebisingan kemudian membersihkan bising latar belakang yang tersisa.
Perangkat dikontrol suara terbagi menjadi dua kategori: near-field (headset, earbuds) dan far-field (speaker pintar, TV). Unit near-field biasanya menggunakan satu atau dua mikrofon, sementara unit far-field menempatkan tiga hingga delapan mikrofon. Yang terakhir menghadapi lingkungan akustik yang lebih keras—suara memudar dengan jarak, kebisingan latar tetap konstan, dan gema menyulitkan ekstraksi sinyal.
Unit far-field menggunakan beamforming, teknik yang menghitung arah sumber dari selisih waktu di antaramikrofon. Ini memungkinkan sistem untuk fokus pada pengguna, mengabaikan refleksi, melacak gerakan, dan mengisolasi satu pembicara ketika beberapa suara hadir.
Deteksi kata pemicu (misalnya, “Alexa”) adalah fitur penting. Mendengarkan terus-menerus menimbulkan masalah privasi; oleh karena itu, banyak sistem melakukan pengenalan kata wake secara lokal, mengirim audio ke cloud hanya setelah perintah lengkap terdeteksi.
Sampel suara yang dibersihkan di-encode sebelum transmisi ke backend cloud untuk analisis yang lebih dalam.
Solusi Khusus
Pemrosesan front-end harus cepat, akurat, dan hemat daya—terutama untuk wearable beroperasi baterai. DSP atau CPU umumnya kesulitan memenuhi tuntutan ini dalam hal biaya, ukuran, dan konsumsi energi. Solusinya adalah DSP khusus yang dirancang untuk tugas audio.
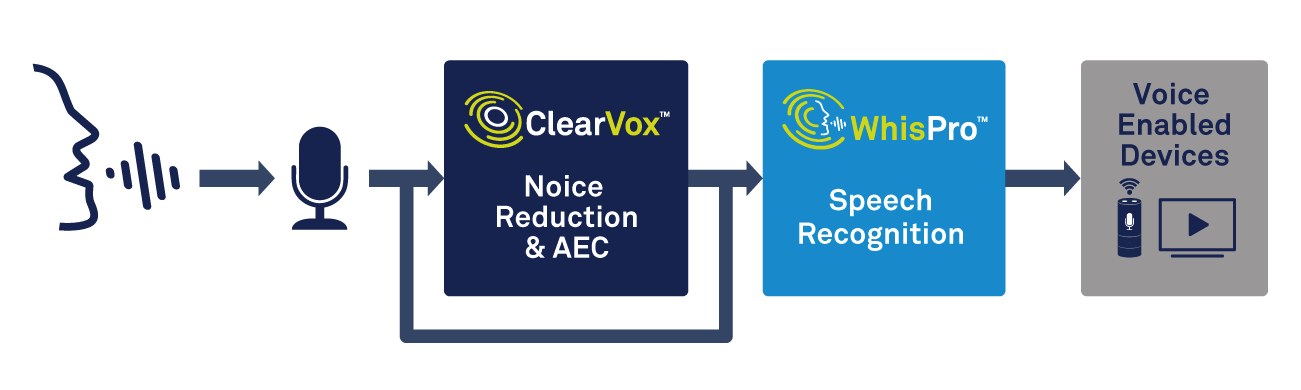
ClearVox CEVA adalah suite perangkat lunak yang menangani beamforming multi-mikrofon, estimasi arah kedatangan, penekanan kebisingan, dan AEC di berbagai skenario akustik. Dioptimalkan untuk DSP suara CEVA, ClearVox menyediakan jalur rendah biaya, rendah daya untuk tangkapan suara berkualitas tinggi.
Deteksi kata pemicu ditangani oleh WhisPro CEVA, pengenali berbasis jaringan syaraf tiruan eksklusif untuk DSP CEVA. WhisPro memprosesor utama tidur hingga kata wake terdeteksi, mengurangi daya sistem secara keseluruhan sambil mempertahankan tingkat pengenalan >95%. Ia mendukung beberapa frasa pemicu dan kata kustom, faktor kritis untuk kepuasan konsumen.
klik untuk gambar lebih besar Gambar 2: Menggunakan pemrosesan suara dan pengenalan ucara untuk aktivasi suara. (Sumber: CEVA)
Pengenalan Ucara: Lokal atau Cloud
Setelah audio bersih dan di-digitalkan, langkah berikutnya adalah pengenalan ucara otomatis (ASR). Spektrum berkisar dari deteksi kata kunci sederhana hingga pemrosesan bahasa alami (NLP) skala penuh. Deteksi kata kunci ideal untuk perangkat cakupan sempit (misalnya, termostat pintar), memungkinkan respons offline dan instan.
Sebaliknya, banyak aplikasi memerlukan pemahaman kontekstual. Permintaan seperti “Tunjukkan hotel dengan nilai bagus di dekat pusat kota” harus diurai untuk niat, entitas, dan konteks lanjutan—pekerjaan yang biasanya menuntut inferensi jaringan syaraf tiruan yang jauh melampaui kemampuan chip edge hemat daya.
Pemrosesan berbasis cloud menawarkan daya komputasi untuk memberikan NLP yang canggih, dengan biaya latensi dan koneksi internet. Namun, solusi edge semakin berkembang; prosesor AI NeuPro CEVA membawa inferensi jaringan syaraf tiruan on-device ke edge, memungkinkan respons lokal yang lebih cerdas dan lebih cepat sambil masih dapat fallback ke cloud ketika diperlukan.
Memilih antara edge dan cloud melibatkan trade-off. Pemrosesan lokal unggul dalam kecepatan dan privasi tetapi kesulitan dengan kueri kompleks. Pemrosesan cloud menskala ke NLP kompleks tetapi memperkenalkan latensi dan ketergantungan pada konektivitas.
Kesimpulan
Antarmuka suara dengan cepat menjadi tonggak utama teknologi sehari-hari. Kemajuan berkelanjutan dalam pemrosesan sinyal, ASR, dan AI—dikombinasikan dengan hardware khusus—mendorong akurasi yang lebih tinggi, daya lebih rendah, dan biaya yang lebih terjangkau.
OEM yang mengadopsi solusi khusus seperti ClearVox, WhisPro, dan NeuPro dapat memenuhi target kinerja, biaya, dan daya yang ketat sambil mempercepat waktu ke pasar.
Seiring maturnya teknologi suara, kita dapat mengharapkan interaksi yang lebih alami dan cakupan aplikasi yang lebih luas—perjalanan yang menarik yang akan mengubah cara kita terlibat dengan perangkat.