Latih Perceptron Lapisan Ganda Anda: Strategi Terbukti untuk Performa Optimal
Kami dapat meningkatkan performa Perceptron secara besar-besaran dengan menambahkan lapisan node tersembunyi, tetapi node tersembunyi juga membuat pelatihan sedikit lebih rumit.
Sampai sekarang dalam seri jaringan syaraf tiruan AAC, Anda telah mempelajari klasifikasi data menggunakan jaringan syaraf tiruan, terutama jenis Perceptron.
Selesaikan seri di bawah ini atau langsung ke entri baru ini yang akan menjelaskan dasar-dasar jaringan syaraf tiruan perceptron lapisan ganda (MLP).
- Bagaimana Melakukan Klasifikasi Menggunakan Jaringan Syaraf Tiruan: Apa Itu Perceptron?
- Bagaimana Menggunakan Contoh Jaringan Syaraf Tiruan Perceptron Sederhana untuk Mengklasifikasikan Data
- Bagaimana Melatih Jaringan Syaraf Tiruan Perceptron Dasar
- Memahami Pelatihan Jaringan Syaraf Tiruan Sederhana
- Pengantar Teori Pelatihan untuk Jaringan Syaraf Tiruan
- Memahami Learning Rate dalam Jaringan Syaraf Tiruan
- Machine Learning Tingkat Lanjut dengan Perceptron Lapisan Ganda
- Fungsi Aktivasi Sigmoid: Aktivasi dalam Jaringan Syaraf Tiruan Perceptron Lapisan Ganda
- Bagaimana Melatih Jaringan Syaraf Tiruan Perceptron Lapisan Ganda
- Memahami Rumus Pelatihan dan Backpropagation untuk Perceptron Lapisan Ganda
- Arsitektur Jaringan Syaraf Tiruan untuk Implementasi Python
- Bagaimana Membuat Jaringan Syaraf Tiruan Perceptron Lapisan Ganda dalam Python
- Pemrosesan Sinyal Menggunakan Jaringan Syaraf Tiruan: Validasi dalam Desain Jaringan Syaraf Tiruan
- Dataset Pelatihan untuk Jaringan Syaraf Tiruan: Bagaimana Melatih dan Memvalidasi Jaringan Syaraf Tiruan Python
Apa Itu Jaringan Syaraf Tiruan Perceptron Lapisan Ganda?
Artikel sebelumnya telah mendemonstrasikan bahwa Perceptron satu lapisan secara sederhana tidak dapat menghasilkan jenis performa yang kami harapkan dari arsitektur jaringan syaraf tiruan modern. Sistem yang terbatas pada fungsi yang dapat dipisahkan secara linier tidak akan dapat mendekati hubungan input-output kompleks yang terjadi dalam skenario pemrosesan sinyal kehidupan nyata. Solusinya adalah Perceptron Lapisan Ganda (MLP), seperti ini:
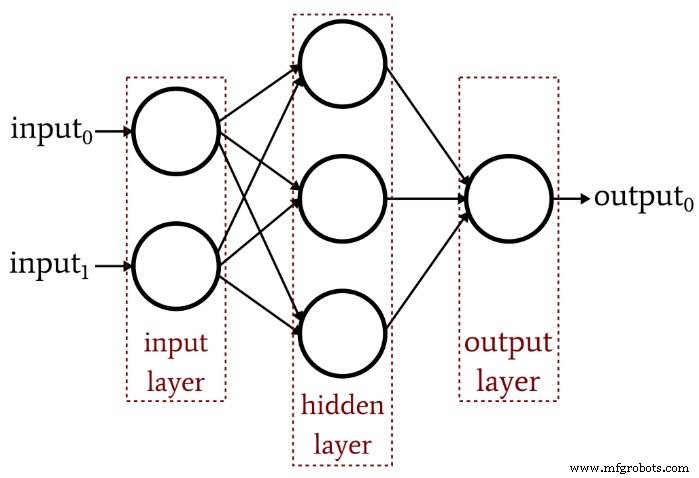
Dengan menambahkan lapisan tersembunyi ini, kita mengubah jaringan menjadi "universal approximator" yang dapat mencapai klasifikasi yang sangat canggih. Tapi kita selalu harus mengingat bahwa nilai jaringan syaraf tiruan sepenuhnya bergantung pada kualitas pelatihannya. Tanpa data pelatihan yang melimpah dan beragam serta prosedur pelatihan yang efektif, jaringan tidak akan pernah "belajar" cara mengklasifikasikan sampel input.
Mengapa Lapisan Tersembunyi Membuat Pelatihan Lebih Rumit?
Mari kita lihat aturan pembelajaran yang kami gunakan untuk melatih Perceptron satu lapisan dalam artikel sebelumnya:
\[w_{new} = w+(\alpha\times(output_{expected}-output_{calculated})\times input)\]
Perhatikan asumsi implisit dalam persamaan ini: Kita memperbarui bobot berdasarkan output yang diamati, sehingga agar ini bekerja, bobot dalam Perceptron satu lapisan harus mempengaruhi nilai output secara langsung. Ini seperti memilih suhu air keran dengan memutar dua knob untuk air panas dan dingin. Hubungan antara suhu keseluruhan dan tindakan knob cukup sederhana, dan bahkan orang yang tidak suka matematika dapat menemukan suhu air yang diinginkan dengan bermain-main dengan knob untuk sementara waktu.
Tapi bayangkan sekarang bahwa aliran air melalui pipa panas dan dingin berhubungan dengan posisi knob dengan cara yang kompleks dan sangat nonlinier. Anda memutar knob untuk air panas dengan perlahan dan tetap, tetapi debit yang dihasilkan bervariasi secara tidak teratur. Anda mencoba knob untuk air dingin dan ia melakukan hal yang sama. Menyelesaikan suhu air yang ideal dalam kondisi ini—terutama karena "output" harus dicapai melalui kombinasi dari dua hubungan kontrol yang membingungkan—akan jauh lebih sulit.
Ini adalah cara saya memahami dilema lapisan tersembunyi. Bobot yang menghubungkan node input ke node tersembunyi secara konseptual analog dengan knob yang bergerak secara tidak teratur secara mekanis—karena bobot input-ke-tersembunyi tidak memiliki jalur langsung ke lapisan output, hubungan antara bobot ini dan output jaringan begitu kompleks sehingga aturan pembelajaran sederhana di atas tidak akan efektif.
Paradigma Pelatihan Baru
Karena aturan pembelajaran Perceptron asli tidak dapat diterapkan pada jaringan lapisan ganda, kita perlu memikirkan ulang strategi pelatihan kami. Apa yang akan kita lakukan adalah mengintegrasikan gradient descent dan minimisasi fungsi error.
Satu hal yang perlu diingat adalah bahwa prosedur pelatihan ini tidak spesifik untuk jaringan syaraf tiruan lapisan ganda. Gradient descent berasal dari teori optimisasi umum, dan prosedur pelatihan yang kami gunakan untuk MLP juga berlaku untuk jaringan satu lapisan. Namun, sejauh yang saya pahami, gradient descent gaya MLP (secara teoretis) tidak diperlukan untuk Perceptron satu lapisan, karena aturan sederhana yang ditunjukkan di atas akan akhirnya menyelesaikan pekerjaan.
Memperoleh persamaan pembaruan bobot aktual untuk MLP melibatkan matematika yang menakutkan yang saya tidak akan mencoba menjelaskan secara cerdas pada titik ini. Tujuan saya untuk bagian sisa artikel ini adalah untuk memberikan pengenalan konseptual tentang dua aspek kunci pelatihan MLP—gradient descent dan fungsi error—dan kemudian kita akan melanjutkan diskusi ini dalam artikel berikut dengan menggabungkan fungsi aktivasi baru.
Gradient Descent
Seperti namanya, gradient descent adalah cara untuk menuju minimum fungsi error berdasarkan kemiringan. Diagram di bawah ini menyampaikan cara gradien memberikan informasi tentang bagaimana memodifikasi bobot—kemiringan suatu titik pada fungsi error memberitahu kita arah mana yang harus ditempuh dan seberapa jauh kita dari minimum.
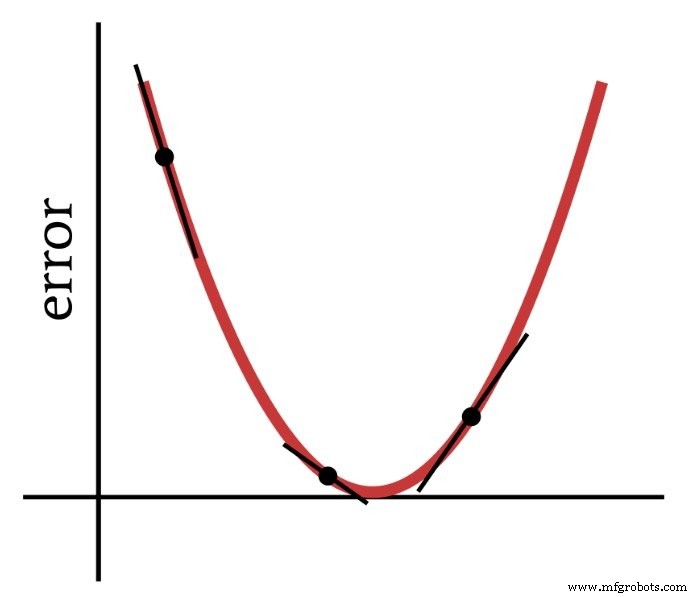
Jadi, turunan fungsi error adalah elemen penting dalam komputasi yang kami gunakan untuk melatih Perceptron Lapisan Ganda. Sebenarnya, kami akan membutuhkan turunan parsial di sini. Ketika kami mengimplementasikan gradient descent, kami membuat setiap modifikasi bobot proporsional terhadap kemiringan fungsi error terhadap bobot yang dimodifikasi.
Fungsi Error (AKA Loss Function)
Metode umum untuk mengukur error jaringan syaraf tiruan adalah dengan mengkuadratkan selisih antara nilai yang diharapkan (atau "target") dan nilai yang dihitung untuk setiap node output, lalu menjumlahkan semua selisih kuadrat ini. Anda dapat menyebutnya "sum of squared difference" atau "summed squared error" atau berbagai hal lain, dan Anda juga akan melihat singkatan LMS, yang berarti least-mean-square, karena tujuan pelatihan adalah meminimalkan mean squared error. Fungsi error (dinyatakan dengan E) dapat diekspresikan secara matematis sebagai berikut:
\[E=\frac{1}{2}\sum_k(t_k-o_k)^2\]
di mana k menunjukkan rentang node output, t adalah nilai output target, dan o adalah nilai output yang dihitung.
Kesimpulan
Kami telah menyiapkan dasar untuk melatih Perceptron Lapisan Ganda dengan sukses, dan kami akan terus menjelajahi topik menarik ini dalam artikel berikutnya.



