Mempersingkat Pengembangan Visual SLAM untuk Sistem Embedded
Simultaneous Localization and Mapping (SLAM) memungkinkan perangkat—baik robot, drone, atau kendaraan otonom—untuk membangun peta waktu nyata dari lingkungan sekitarnya sambil sekaligus menentukan posisinya di dalam peta tersebut. SLAM dapat diimplementasikan dengan berbagai algoritma dan sensor, dari kamera dan LiDAR hingga sonar, radar, dan satuan pengukuran inersial (IMU).
Kamera yang murah dan kompak telah menjadikan Visual SLAM monokular sebagai solusi pilihan untuk banyak robot, dari rover Mars dan mesin pertanian lapangan hingga drone pengiriman dan platform otonom perkotaan. Visual SLAM unggul di lingkungan yang ditolak GPS, seperti gudang indoor atau pusat kota yang padat di mana sinyal satelit terhalang atau degradasi.
Artikel ini menjelaskan alur kerja visual SLAM inti, mencakup modul dan algoritma utama untuk deteksi fitur, pencocokan, dan koreksi kesalahan. Ini juga membahas manfaat pengalihan komputasi SLAM ke unit pemrosesan visi khusus (VPU) dan mengilustrasikan keuntungan ini dengan CEVA-SLAM SDK.
Direct vs. Feature-Based SLAM
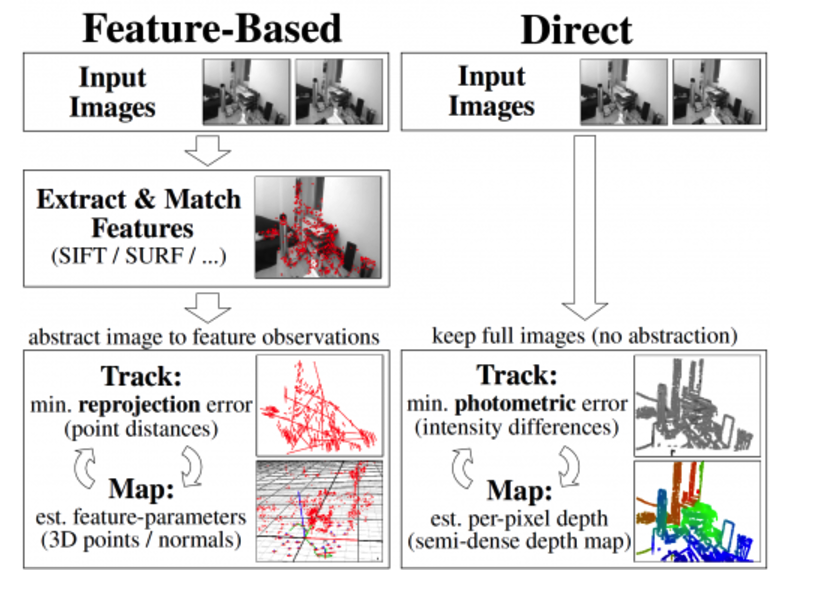
Semua sistem visual SLAM melacak titik di seluruh bingkai kamera berurutan, triangulasi posisi 3D mereka sambil mengestimasi pose kamera. Mereka juga terus meminimalkan kesalahan reproyeksi—selisih antara lokasi fitur yang diproyeksikan dan aktual. Perbedaan utama terletak pada bagaimana informasi gambar digunakan.
Direct SLAM membandingkan seluruh gambar, menyediakan detail lingkungan yang kaya dengan biaya beban pemrosesan yang lebih tinggi. Feature-based SLAM, yang menjadi fokus tulisan ini, mengekstrak fitur gambar yang berbeda—sudut, blob, dan titik salien lainnya—dan bergantung sepenuhnya pada ini untuk estimasi pose. Meskipun metode berbasis fitur mengorbankan beberapa data gambar, mereka menawarkan solusi yang lebih sederhana, lebih cepat, dan lebih hemat daya, terutama untuk hardware embedded.
Gambar 1: Direct vs. Feature-Based SLAM. (Sumber: https://vision.in.tum.de/research/vslam/lsdslam)
Alur Kerja Visual SLAM
Feature-based SLAM melalui empat tahap esensial: 1) ekstraksi fitur, 2) deskripsi fitur, 3) pencocokan fitur, dan 4) penutupan loop. Tahap-tahap ini dibangun pada serangkaian blok konstruksi yang terjamin yang dapat disesuaikan dengan berbagai implementasi SLAM.
Ekstraksi Fitur
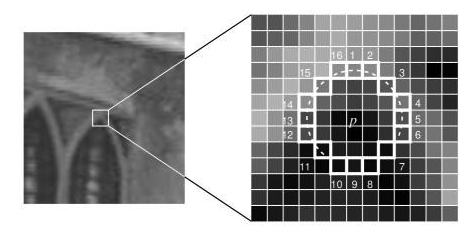
Ekstraksi fitur menyaring gambar menjadi seperangkat titik salien yang ringkas—sudut, tepi, blob, dan struktur kompleks seperti pintu atau jendela—direpresentasikan sebagai vektor kompakt. Algoritma populer meliputi Difference of Gaussian (DoG) dan detektor sudut FAST9 yang cepat, waktu nyata.
Gambar 2: Ekstraksi Fitur SLAM. (Sumber: https://medium.com/towards-artificial-intelligence/oriented-fast-and-rotated-brief-orb-1da5b2840768)
Deskripsi Fitur
Setelah fitur ditemukan, patch piksel di sekitarnya diubah menjadi deskriptor—representasi kompat yang dapat dibandingkan dengan deskriptor lain. ORB dan FREAK adalah algoritma deskriptor yang banyak digunakan, menyeimbangkan kesalahan dengan efisiensi komputasi.
Pencocokan Fitur
Deskriptor dari bingkai berurutan dicocokkan dengan menghitung jarak Hamming antara bit-vector. Metrik ini dapat dievaluasi secara efisien pada hardware menggunakan operasi XOR dan pop-count, memungkinkan pencocokan yang cepat bahkan pada perangkat dengan sumber daya terbatas.
Penutupan Loop
Penutupan loop mendeteksi saat sistem kembali ke lokasi yang sebelumnya dilihat. Dengan memperkenalkan batasan di antara bingkai non-bersebelahan, ini secara dramatis mengurangi drift yang terakumulasi. Teknik penutupan loop terdekat termasuk bundle adjustment, filter Kalman, dan filter partikel.
Feature-based SLAM sangat cocok untuk solusi embedded, memberikan pemrosesan yang lebih cepat, penggunaan memori yang lebih rendah, dan performa yang kuat di seluruh pencahayaan yang bervariasi, gerakan buram, dan oklusi. Pilihan algoritma spesifik bergantung pada tipe peta aplikasi, suite sensor, persyaratan akurasi, dan keterbatasan lainnya.
Tantangan Implementasi
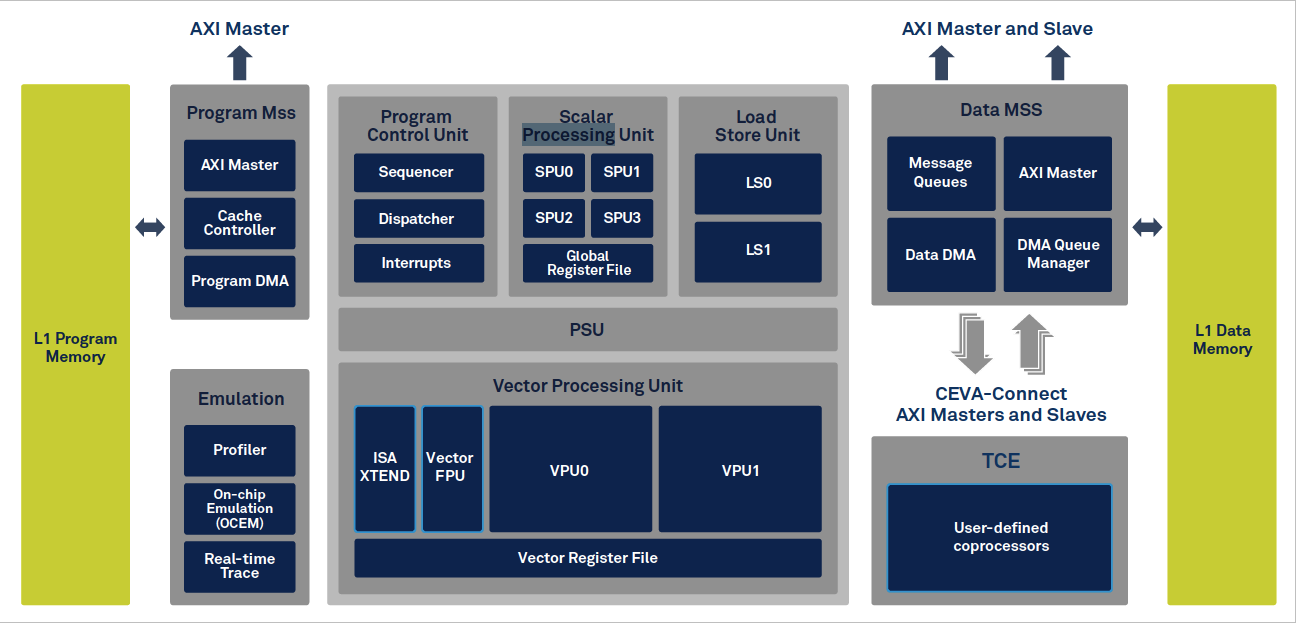
Intensitas komputasi visual SLAM dapat membanjiri CPU konvensional, meningkatkan konsumsi daya dan membatasi tingkat bingka. VPU khusus, seperti CEVA-XM6, menyediakan arsitektur khusus yang diperlukan untuk mempercepat tugas visi, menawarkan konsumsi daya rendah, ALU yang kuat, akses memori throughput tinggi, dan instruksi khusus untuk pemrosesan gambar.
Gambar 3: CEVA XM6 Vision Processing Unit. (Sumber: CEVA)
Bahkan dengan VPU, pengembang menghadapi tantangan: menulis kode yang efisien untuk pencocokan fitur, bundle adjustment, dan operasi linear-algebra lainnya; mengelola tata letak memori untuk menghindari akses non-kontigu yang mahal; dan mengintegrasikan VPU dengan CPU host. Pustaka tingkat tinggi dan rutinitas yang dioptimalkan esensial untuk membuka potensi penuh VPU.
Mempercepat Pengembangan dengan CEVA-SLAM SDK
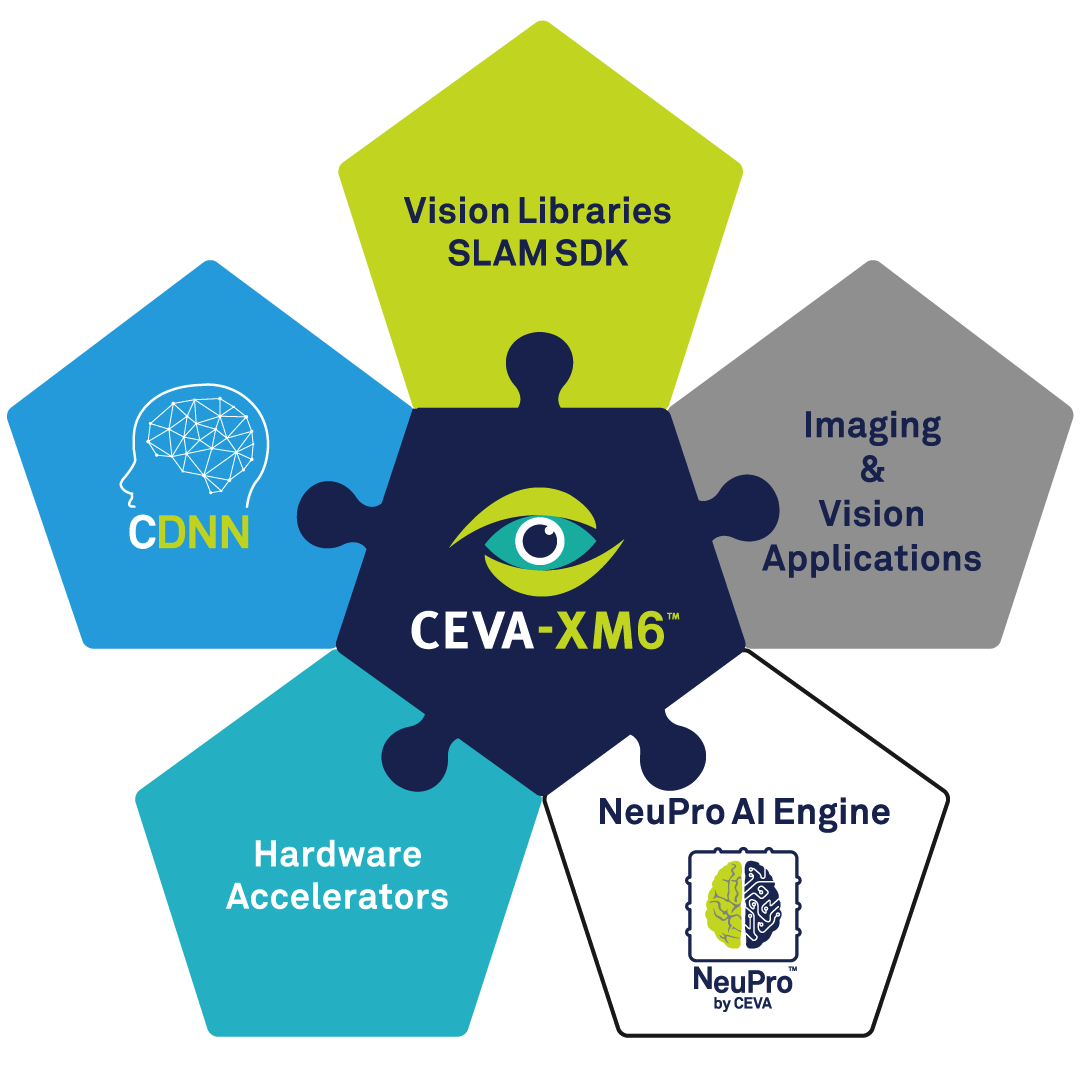
CEVA-SLAM SDK adalah toolchain komprehensif yang menggabungkan hardware CEVA-XM6 dengan serangkaian pustaka visi yang kaya. Ini menyediakan rutinitas yang telah dioptimalkan untuk deteksi fitur, ekstraksi deskriptor, pencocokan, bundle adjustment, dan operasi linear-algebra. Instruksi parallel-load unik menangani akses memori non-konsekutif, sementara instruksi jarak Hamming khusus mempercepat pencocokan.
Gambar 4: CEVA SLAM SDK. (Sumber: CEVA)
Dalam implementasi benchmarks, SDK mencapai 60 fps pelacakan SLAM sambil mengkonsumsi hanya 86 mW—tingkat kinerja yang akan sulit tercapai pada CPU umum.
Kesimpulan
Visual SLAM dengan cepat menjadi teknologi tonggak untuk robot otonom, drone, dan kendaraan pintar. Seiring pertumbuhan penerapan embedded, efisiensi kode dan konsumsi daya menjadi faktor penentu. Sementara VPU mengalihkan beban kerja visi yang berat, mengembangkan solusi SLAM yang berkinerja tinggi dan hemat daya tetap tidak mudah. Dengan memanfaatkan toolkit khusus seperti CEVA-SLAM SDK, pengembang dapat mempercepat waktu ke pasar dan menyampaikan solusi SLAM yang andal dan hemat energi.