Merancang Perceptron Jaringan Syaraf Tiruan Fleksibel dengan Python
Membangun Perceptron untuk Klasifikasi: Arsitektur, Bias, dan Aktivasi
Selamat datang di seri jaringan syaraf tiruan All About Circuits. Postingan sebelumnya kami telah membahas fondasi teoretis jaringan syaraf tiruan:
- Bagaimana Melakukan Klasifikasi Menggunakan Jaringan Syaraf Tiruan: Apa Itu Perceptron?
- Bagaimana Menggunakan Contoh Jaringan Syaraf Tiruan Perceptron Sederhana untuk Mengklasifikasikan Data
- Bagaimana Melatih Jaringan Syaraf Tiruan Perceptron Dasar
- Memahami Pelatihan Jaringan Syaraf Tiruan Sederhana
- Pengantar Teori Pelatihan untuk Jaringan Syaraf Tiruan
- Memahami Learning Rate dalam Jaringan Syaraf Tiruan
- Machine Learning Tingkat Lanjut dengan Perceptron Lapisan Ganda
- Fungsi Aktivasi Sigmoid: Aktivasi dalam Jaringan Syaraf Tiruan Perceptron Lapisan Ganda
- Bagaimana Melatih Jaringan Syaraf Tiruan Perceptron Lapisan Ganda
- Memahami Rumus Pelatihan dan Backpropagation untuk Perceptron Lapisan Ganda
- Arsitektur Jaringan Syaraf Tiruan untuk Implementasi Python
- Bagaimana Membuat Jaringan Syaraf Tiruan Perceptron Lapisan Ganda dalam Python
- Pemrosesan Sinyal Menggunakan Jaringan Syaraf Tiruan: Validasi dalam Desain Jaringan Syaraf Tiruan
- Dataset Pelatihan untuk Jaringan Syaraf Tiruan: Bagaimana Melatih dan Memvalidasi Jaringan Syaraf Tiruan Python
Kami sekarang siap untuk menerjemahkan teori ini ke dalam sistem klasifikasi Perceptron yang bekerja. Bagian berikut merinci arsitektur yang akan kami implementasikan dalam Python, dengan pilihan desain yang jelas yang membuat kode dapat dipindahkan ke bahasa lain seperti C.
Arsitektur Jaringan Syaraf Tiruan Python
Diagram di bawah ini mengilustrasikan struktur jaringan yang akan kami kode:
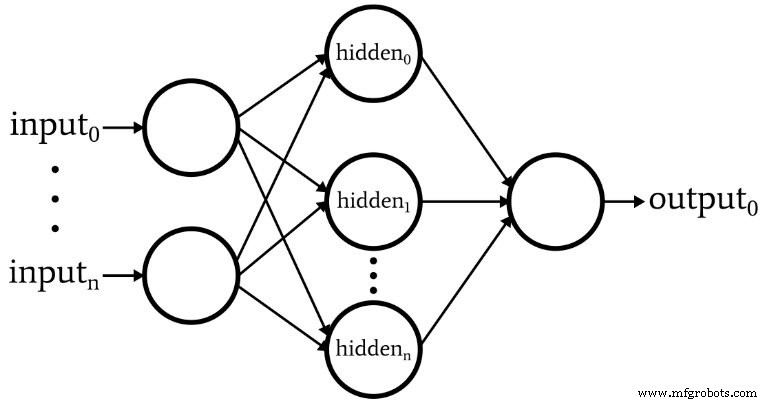
- Node input variabel – Esensial untuk mencocokkan dimensialitas data dunia nyata.
- Hanya satu lapisan tersembunyi – Satu lapisan tersembunyi sudah cukup untuk banyak tugas klasifikasi, menyederhanakan implementasi.
- Node tersembunyi variabel – Jumlah optimal ditemukan secara empiris; kami akan membahas heuristik dalam postingan mendatang.
- Node output tetap (1) – Menyederhanakan program awal; versi mendatang dapat mendukung output multi-kelas.
- Fungsi aktivasi – Lapisan tersembunyi dan output menggunakan logistic sigmoid: f(x)=1/(1+e^{-x}).
Apa Itu Node Bias? (Bias Meningkatkan Fleksibilitas Perceptron)
Node bias—atau bias—adalah konstanta yang ditambahkan ke jumlah terbobot suatu node sebelum aktivasi. Biasanya diatur ke 1 dan dapat ditempatkan di lapisan input atau tersembunyi.
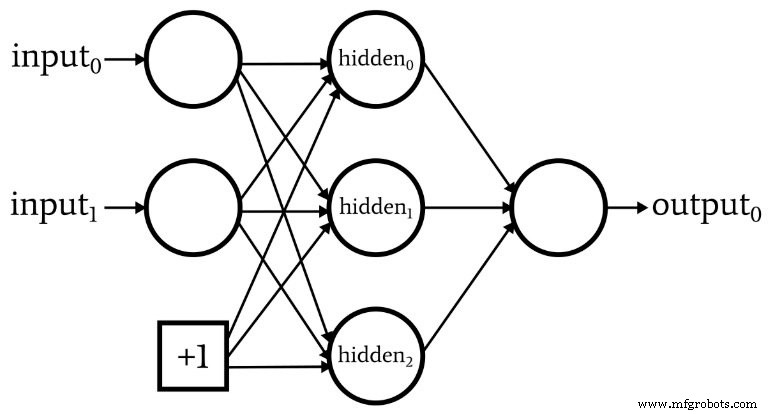
Bobot bias diperbarui seperti bobot lainnya selama backpropagation. Menyertakan node bias memungkinkan jaringan untuk menggeser batas keputusannya, meningkatkan performa pada data yang tidak dapat dipisahkan secara linier.
Dalam Bagian 10 dari seri ini, kami menjelaskan pre-aktivasi sebagai dot product: S_preA = w · x = Σ(w_i x_i). Menambahkan bias b memodifikasinya menjadi:
S_preA = (w · x) + b = Σ(w_i x_i) + b
Bias secara efektif bertindak seperti intersep y dalam persamaan linier y = mx + b, menggeser kurva aktivasi secara horizontal.
Bobot, Bias, dan Aktivasi
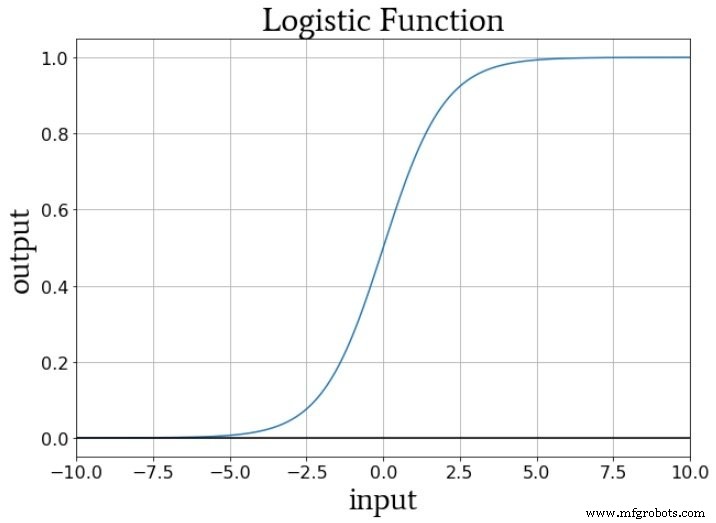
Selama pelatihan, bobot menskalakan kemiringan input, sementara bias menggesernya secara vertikal. Dengan logistic sigmoid f_A(x) = 1/(1+e^{-x}), transisi dari 0 ke 1 berpusat pada x = 0. Menyesuaikan bias memindahkan transisi ke kiri atau kanan, dan magnitudo bobot mengontrol kekakuan transisi.
Kesimpulan
Kami telah merinci pilihan arsitektur inti untuk Perceptron kami dan menjelaskan peran node bias. Dalam artikel berikutnya, kami akan menyelami kode Python yang mewujudkan desain ini.



