Membangun Jaringan Syaraf Tiruan Perceptron Lapisan Ganda dengan Python: Panduan Praktis
Artikel ini memandu Anda melalui program Python yang melatih jaringan syaraf tiruan untuk klasifikasi lanjutan.
Ini adalah entri ke-12 dalam seri pengembangan jaringan syaraf tiruan AAC. Lihat apa lagi yang ditawarkan seri ini di bawah ini:
- Bagaimana Melakukan Klasifikasi Menggunakan Jaringan Syaraf Tiruan: Apa Itu Perceptron?
- Bagaimana Menggunakan Contoh Jaringan Syaraf Tiruan Perceptron Sederhana untuk Mengklasifikasikan Data
- Bagaimana Melatih Jaringan Syaraf Tiruan Perceptron Dasar
- Memahami Pelatihan Jaringan Syaraf Tiruan Sederhana
- Pengantar Teori Pelatihan untuk Jaringan Syaraf Tiruan
- Memahami Learning Rate dalam Jaringan Syaraf Tiruan
- Machine Learning Tingkat Lanjut dengan Perceptron Lapisan Ganda
- Fungsi Aktivasi Sigmoid: Aktivasi dalam Jaringan Syaraf Tiruan Perceptron Lapisan Ganda
- Bagaimana Melatih Jaringan Syaraf Tiruan Perceptron Lapisan Ganda
- Memahami Rumus Pelatihan dan Backpropagation untuk Perceptron Lapisan Ganda
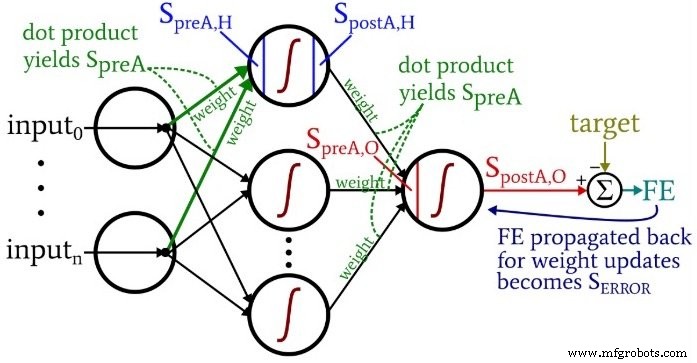
- Arsitektur Jaringan Syaraf Tiruan untuk Implementasi Python
- Bagaimana Membuat Jaringan Syaraf Tiruan Perceptron Lapisan Ganda dalam Python
- Pemrosesan Sinyal Menggunakan Jaringan Syaraf Tiruan: Validasi dalam Desain Jaringan Syaraf Tiruan
- Dataset Pelatihan untuk Jaringan Syaraf Tiruan: Bagaimana Melatih dan Memvalidasi Jaringan Syaraf Tiruan Python
Dalam artikel ini, kami akan membangun pada pekerjaan kami dengan jaringan perceptron sederhana dan memperluasnya ke dalam perceptron lapisan ganda (MLP) yang fungsional sepenuhnya yang diimplementasikan dalam Python.
Mengembangkan Kode Python yang Mudah Dipahami untuk Jaringan Syaraf Tiruan
Setelah meninjau banyak sumber daya online, saya menemukan bahwa banyak implementasi atau terlalu kompleks atau kurang jelas. Tujuan saya adalah untuk membuat program yang edukatif dan intuitif, yang memungkinkan pembaca melihat bagaimana teori diterjemahkan menjadi kode.
Sementara skrip ini memprioritaskan keterbacaan di atas kinerja mentah, ini tetap menjadi dasar yang kokoh untuk eksperimen. Aplikasi dunia nyata sering memerlukan kode yang dioptimalkan untuk menangani dataset yang besar, tetapi untuk pembelajaran dan proyek skala kecil, keterjelasan lebih berharga.
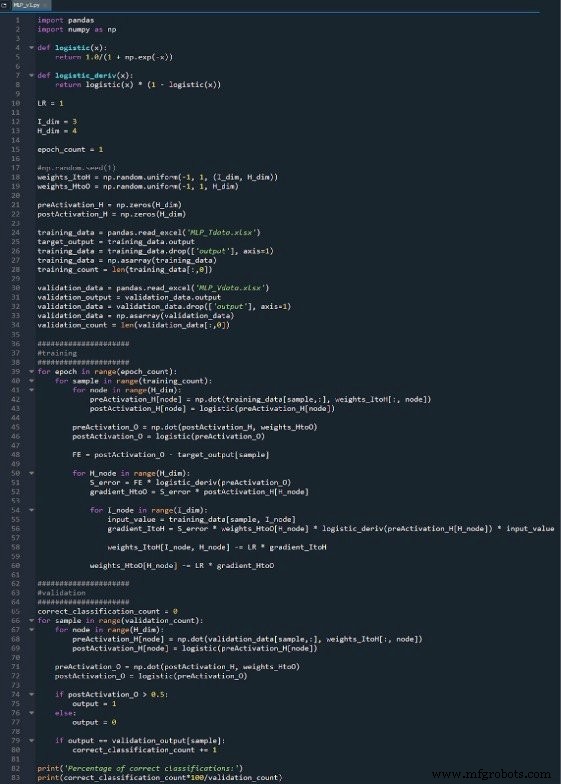
Sumber Python lengkap tersedia sebagai gambar di bawah ini dan dapat diunduh sebagai MLP_v1.py. Kode melakukan pelatihan dan validasi, dengan fokus postingan ini pada proses pelatihan.
Mempersiapkan Fungsi dan Variabel
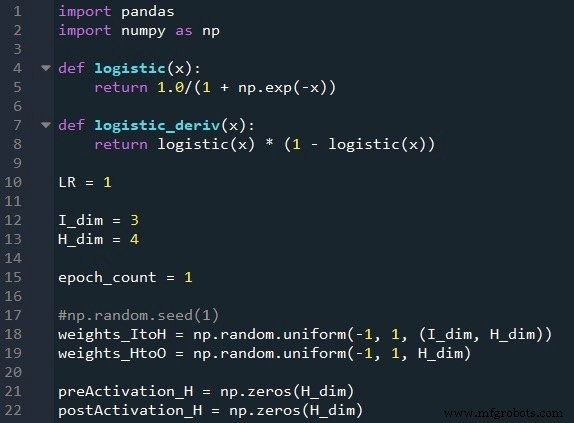
Pustaka NumPy menangani semua operasi numerik, sementara Pandua memfasilitasi impor data pelatihan dari Excel dengan mudah. Kami menggunakan fungsi aktivasi logistic sigmoid dan turunannya untuk backpropagation. Learning rate, dimensi input, ukuran lapisan tersembunyi, dan jumlah epoch diatur di sini. Bobot awal acak dihasilkan dengan np.random.uniform(-1, 1), dan seed tetap memastikan reproduktibilitas. Array kosong untuk nilai pre-activation dan post-activation tersembunyi juga diinisialisasi.
Mengimpor Data Pelatihan
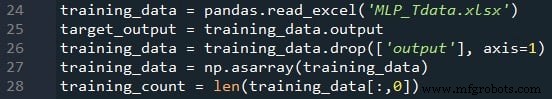
Mengikuti prosedur dari Bagian 4, kami membaca dataset dari Excel, memisahkan kolom target, menghapusnya dari matriks fitur, mengonversi data yang tersisa ke array NumPy, dan menyimpan jumlah sampel di training_count.
Proses Feedforward
Fase feedforward menghitung output jaringan dengan menyebarkan input melalui lapisan tersembunyi ke node output. Kode di bawah ini menunjukkan loop multi-epoch, perhitungan per sampel, pre-aktivasi dan aktivasi lapisan tersembunyi, dan komputasi output akhir.
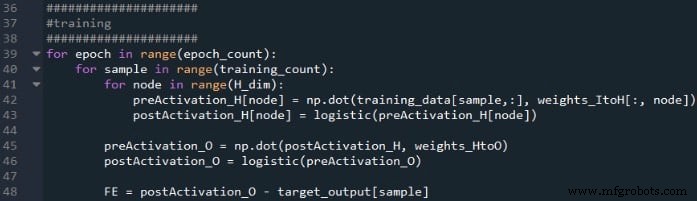
Di dalam setiap epoch, kami mengulangi semua sampel. Untuk setiap sampel, kami menghitung aktivasi node tersembunyi melalui dot products, menerapkan sigmoid, lalu menghitung pre-aktivasi dan post-aktivasi node output. Error adalah selisih antara target dan output.
Backpropagation
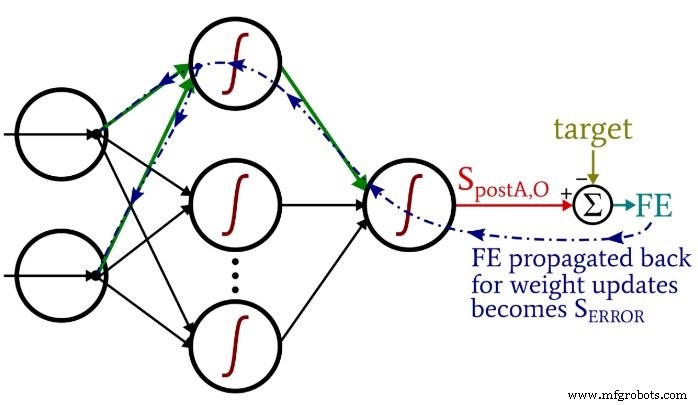
Setelah feedforward, backpropagation menyesuaikan bobot dalam urutan terbalik, menyebarkan sinyal error dari output kembali melalui lapisan tersembunyi. Gambar berikut mengilustrasikan loop bersarang dan pembaruan bobot.
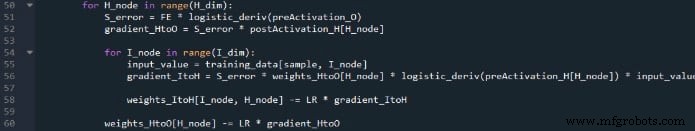
Kami pertama-tama menghitung istilah error output S_ERROR, lalu memperbarui bobot tersembunyi-ke-output. Selanjutnya, untuk setiap node tersembunyi, kami menghitung kontribusinya ke pembaruan bobot input-ke-tersembunyi menggunakan bobot tersembunyi-ke-output saat ini. Urutan ini mempertahankan perhitungan gradien yang benar.
Kesimpulan
Skrip ringkas ini mengenkapsulasi prinsip inti MLP: ingesti data, propagasi maju, komputasi error, dan penyesuaian bobot melalui backpropagation. Saya berharap ini berfungsi sebagai jembatan yang jelas antara teori jaringan syaraf tiruan dan implementasi praktis.
Di bawah ini adalah kode lengkap untuk referensi:
Download Code



