Memahami Hadoop: Panduan Pemrosesan Big Data
Evolusi big data telah menghasilkan tantangan baru yang membutuhkan solusi baru. Seperti tidak pernah terjadi sebelumnya dalam sejarah, server perlu memproses, mengurutkan, dan menyimpan sejumlah besar data secara real-time.
Tantangan ini telah menghasilkan munculnya platform baru, seperti Apache Hadoop, yang dapat menangani kumpulan data besar dengan mudah.
Dalam artikel ini, Anda akan mempelajari apa itu Hadoop, komponen utamanya, dan bagaimana Apache Hadoop membantu dalam pemrosesan big data.
Apa itu Hadoop?
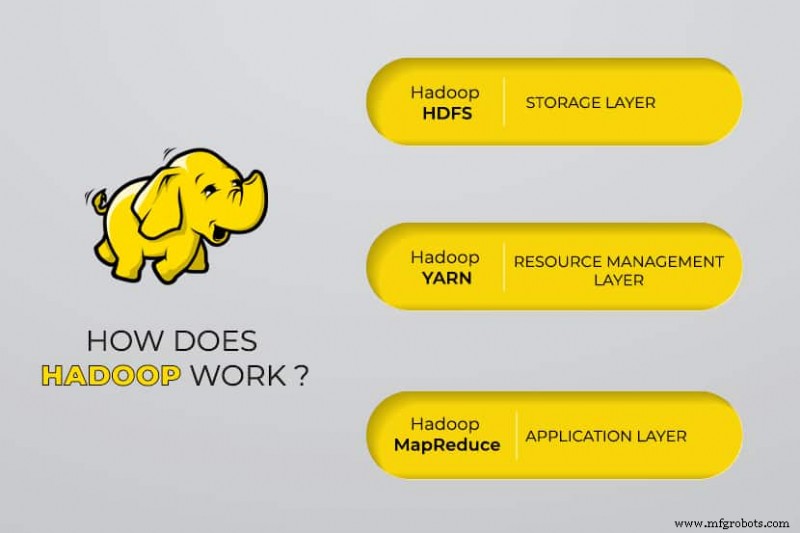
Perpustakaan perangkat lunak Apache Hadoop adalah framework open source yang memungkinkan Anda mengelola dan memproses big data secara efisien dalam lingkungan komputasi terdistribusi.
Apache Hadoop terdiri dari empat modul utama:
Hadoop Distributed File System (HDFS)
Data berada dalam Sistem File Terdistribusi Hadoop, yang mirip dengan sistem file lokal pada komputer biasa. HDFS menyediakan throughput data yang lebih baik dibandingkan sistem file tradisional.
Selain itu, HDFS menyediakan skalabilitas yang excelente. Anda dapat menskalakan dari satu mesin menjadi ribuan dengan mudah dan pada perangkat keras komoditas.
Yet Another Resource Negotiator (YARN)
YARN memfasilitasi tugas terjadwal, manajemen, dan pemantauan node kluster serta sumber daya lainnya.
MapReduce
Modul Hadoop MapReduce membantu program melakukan komputasi data paralel. Tugas Map dari MapReduce mengonversi data input menjadi pasangan kunci-nilai. Tugas Reduce mengonsumsi input, mengagregatnya, dan menghasilkan hasil.
Hadoop Common
Hadoop Common menggunakan perpustakaan Java standar di setiap modul.
Mengapa Hadoop Dikembangkan?
World Wide Web tumbuh eksponensial selama dekade terakhir, dan sekarang terdiri dari miliaran halaman. Mencari informasi online menjadi sulit karena kuantitasnya yang signifikan. Data ini menjadi big data, dan terdiri dari dua masalah utama:
- Kesulitan menyimpan semua data ini secara efisien dan mudah diakses
- Kesulitan memproses data yang disimpan
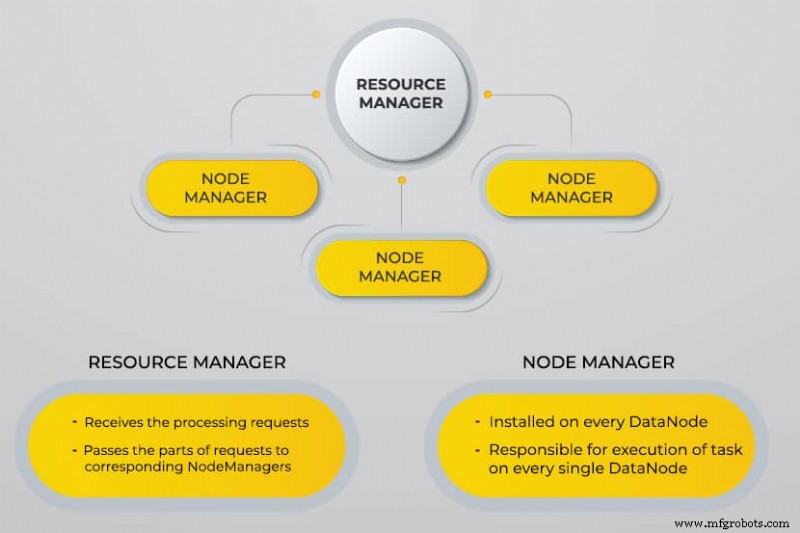
Pengembang bekerja pada banyak proyek open source untuk menghasilkan hasil pencarian web lebih cepat dan efisien dengan mengatasi masalah di atas. Solusi mereka adalah mendistribusikan data dan perhitungan di seluruh kluster server untuk mencapai pemrosesan simultan.
Akhirnya, Hadoop menjadi solusi untuk masalah ini dan membawa banyak manfaat lainnya, termasuk pengurangan biaya penerapan server.
Bagaimana Pemrosesan Big Data Hadoop Bekerja?
Menggunakan Hadoop, kita memanfaatkan kapasitas penyimpanan dan pemrosesan kluster dan menerapkan pemrosesan terdistribusi untuk big data. Pada dasarnya, Hadoop memberikan dasar yang digunakan untuk membangun aplikasi lainnya guna memproses big data.
Aplikasi yang mengumpulkan data dalam berbagai format menyimpannya di kluster Hadoop melalui API Hadoop, yang terhubung ke NameNode. NameNode menangkap struktur direktori file dan penempatan “chunks” untuk setiap file yang dibuat. Hadoop mereplikasi chunks ini di seluruh DataNodes untuk pemrosesan paralel.
MapReduce melakukan kueri data. Ini memetakan semua DataNodes dan mengurangi tugas terkait data di HDFS. Nama, “MapReduce” itu sendiri menjelaskan apa yang dilakukan. Tugas Map berjalan di setiap node untuk file input yang disediakan, sementara reducers berjalan untuk menghubungkan data dan mengorganisir output akhir.
Alat Big Data Hadoop
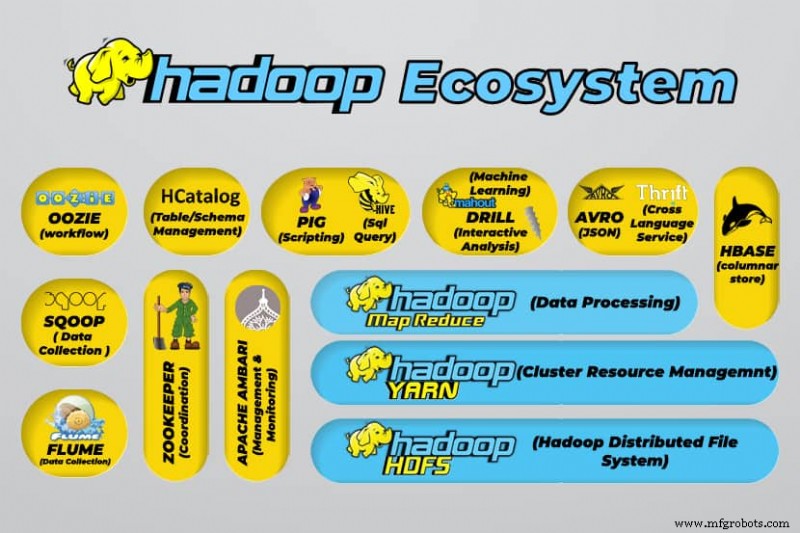
Ekosistem Hadoop mendukung berbagai alat big data open source. Alat-alat ini melengkapi komponen inti Hadoop dan meningkatkan kemampuannya dalam memproses big data.
Alat pemrosesan big data yang paling berguna mencakup:
- Apache Hive
Apache Hive adalah gudang data untuk memproses kumpulan data besar yang disimpan dalam sistem file Hadoop.
- Apache Zookeeper
Apache Zookeeper mengotomatiskan failover dan mengurangi dampak kegagalan NameNode.
- Apache HBase
Apache HBase adalah basis data non-relasional open source untuk Hadoop.
- Apache Flume
Apache Flume adalah layanan terdistribusi untuk streaming sejumlah besar data log.
- Apache Sqoop
Apache Sqoop adalah alat command-line untuk bermigrasi data antara Hadoop dan basis data relasional.
- Apache Pig
Apache Pig adalah platform pengembangan Apache untuk mengembangkan pekerjaan yang berjalan di Hadoop. Bahasa perangkat lunak yang digunakan adalah Pig Latin.
- Apache Oozie
Apache Oozie adalah sistem penjadwalan yang memfasilitasi manajemen pekerjaan Hadoop.
- Apache HCatalog
Apache HCatalog adalah alat manajemen penyimpanan dan tabel untuk mengurutkan data dari berbagai alat pemrosesan data.
Kelebihan Hadoop
Hadoop adalah solusi yang kuat untuk pemrosesan big data dan adalah alat penting untuk bisnis yang berurusan dengan big data.
Fitur utama dan keuntungan Hadoop dijelaskan sebagai berikut:
- Penyimpanan dan pemrosesan data yang lebih cepat
Jumlah data yang akan disimpan meningkat secara dramatis dengan kedatangan media sosial dan Internet of Things (IoT). Penyimpanan dan pemrosesan kumpulan data ini sangat penting bagi bisnis yang memilikinya. - Fleksibilitas
Fleksibilitas Hadoop memungkinkan Anda menyimpan tipe data terstruktur seperti teks, simbol, gambar, dan video. Dalam basis data relasional tradisional seperti RDBMS, Anda perlu memproses data sebelum menyimpannya. Namun, dengan Hadoop, pemrosesan data terlebih dahulu tidak diperlukan karena Anda dapat menyimpan data sebagaimana adanya dan memutuskan cara memprosesnya nanti. Dengan kata lain, ia berperilaku seperti basis data NoSQL. - Kekuatan pemrosesan
Hadoop memproses big data melalui model komputasi terdistribusi. Penggunaan yang efisien dari kekuatan pemrosesan membuatnya cepat dan efisien. - Biaya yang lebih rendah
Banyak tim mengakhiri proyek mereka sebelum kedatangan framework seperti Hadoop, karena biaya tinggi yang mereka tanggung. Hadoop adalah framework open source, gratis untuk digunakan, dan menggunakan perangkat keras komoditas murah untuk menyimpan data. - Skalabilitas
Hadoop memungkinkan Anda untuk menskalakan sistem Anda dengan cepat tanpa banyak administrasi, hanya dengan mengubah jumlah node dalam kluster. - Toleransi kesalahan
Salah satu keuntungan banyak menggunakan model data terdistribusi adalah kemampuannya untuk mentolerir kegagalan. Hadoop tidak bergantung pada perangkat keras untuk menjaga ketersediaan. Jika sebuah perangkat gagal, sistem secara otomatis mengalihkan tugas ke perangkat lain. Toleransi kesalahan mungkin karena data redundan dipertahankan dengan menyimpan beberapa salinan data di seluruh kluster. Dengan kata lain, ketersediaan tinggi dipertahankan di lapisan perangkat lunak.
Tiga Kasus Penggunaan Utama
Pemrosesan big data
Kami merekomendasikan Hadoop untuk sejumlah besar data, biasanya dalam rentang petabyte atau lebih. Ini lebih cocok untuk sejumlah besar data yang memerlukan kekuatan pemrosesan yang besar. Hadoop mungkin bukan opsi terbaik untuk organisasi yang memproses jumlah data yang lebih kecil dalam rentang beberapa ratus gigabyte.
Menyimpan kumpulan data yang beragam
Salah satu keuntungan banyak menggunakan Hadoop adalah ia fleksibel dan mendukung berbagai tipe data. Terlepas dari apakah data terdiri dari teks, gambar, atau data video, Hadoop dapat menyimpannya secara efisien. Organisasi dapat memilih cara memproses data tergantung pada kebutuhan mereka. Hadoop memiliki karakteristik data lake karena ia memberikan fleksibilitas atas data yang disimpan.
Pemrosesan data paralel
Algoritma MapReduce yang digunakan dalam Hadoop mengatur pemrosesan paralel data yang disimpan, berarti Anda dapat mengeksekusi beberapa tugas secara bersamaan. Namun, operasi gabungan tidak diizinkan karena akan membingungkan metodologi standar dalam Hadoop. Ia memasukkan paralelisme selama data independen satu sama lain.
Apa yang Digunakan Hadoop di Dunia Nyata
Perusahaan di seluruh dunia menggunakan sistem pemrosesan big data Hadoop. Beberapa dari banyak penggunaan praktis Hadoop tercantum di bawah ini:
- Memahami kebutuhan pelanggan
Saat ini, Hadoop telah terbukti sangat berguna dalam memahami kebutuhan pelanggan. Perusahaan besar di industri keuangan dan media sosial menggunakan teknologi ini untuk memahami kebutuhan pelanggan dengan menganalisis big data tentang aktivitas mereka.
Perusahaan menggunakan data tersebut untuk memberikan penawaran dipersonalisasi kepada pelanggan. Anda mungkin telah mengalami ini melalui iklan yang ditampilkan di media sosial dan situs eCommerce berdasarkan minat dan aktivitas internet kita. - Mengoptimalkan proses bisnis
Hadoop membantu mengoptimalkan kinerja bisnis dengan menganalisis data transaksi dan pelanggan yang lebih baik. Analisis tren dan analisis prediktif dapat membantu perusahaan menyesuaikan produk dan stok mereka untuk meningkatkan penjualan. Analisis seperti itu akan memfasilitasi pengambilan keputusan yang lebih baik dan mengarah ke keuntungan yang lebih tinggi.
Selain itu, perusahaan menggunakan Hadoop untuk meningkatkan lingkungan kerja mereka dengan memantau perilaku karyawan dengan mengumpulkan data tentang interaksi mereka satu sama lain. - Meningkatkan layanan kesehatan
Lembaga di industri medis dapat menggunakan Hadoop untuk memantau sejumlah besar data mengenai isu kesehatan dan hasil pengobatan medis. Peneliti dapat menganalisis data ini untuk mengidentifikasi isu kesehatan, memprediksi obat, dan memutuskan rencana pengobatan. Peningkatan seperti itu akan memungkinkan negara untuk meningkatkan layanan kesehatan mereka dengan cepat. - Perdagangan keuangan
Hadoop memiliki algoritma yang canggih untuk memindai data pasar dengan pengaturan yang telah ditentukan untuk mengidentifikasi peluang perdagangan dan tren musiman. Perusahaan keuangan dapat mengotomatisasi sebagian besar operasi ini melalui kemampuan kuat Hadoop. - Menggunakan Hadoop untuk IoT
Perangkat IoT bergantung pada ketersediaan data untuk berfungsi secara efisien. Produsen dan penggemar menggunakan Hadoop sebagai gudang data untuk miliaran transaksi. Karena IoT adalah konsep streaming data, Hadoop adalah solusi yang sesuai dan praktis untuk mengelola sejumlah besar data yang dimilikinya.
Hadoop diperbarui secara berkelanjutan, memungkinkan kami untuk meningkatkan instruksi yang digunakan dengan platform IoT.
Penggunaan praktis lainnya dari Hadoop termasuk meningkatkan kinerja perangkat, meningkatkan kuantifikasi pribadi dan optimasi kinerja, meningkatkan riset olahraga dan ilmiah.
Apa Tantangan Menggunakan Hadoop?
Setiap aplikasi datang dengan keuntungan dan tantangan. Hadoop juga memperkenalkan beberapa tantangan:
- Algoritma MapReduce tidak selalu solusi
Algoritma MapReduce tidak mendukung semua skenario. Ia cocok untuk permintaan informasi sederhana dan masalah yang dapat dibagi menjadi unit independen, tetapi tidak untuk tugas iteratif.
MapReduce tidak efisien untuk komputasi analitik lanjutan karena algoritma iteratif memerlukan komunikasi intenstif, dan membuat beberapa file dalam fase MapReduce. - Manajemen data yang sepenuhnya dikembangkan
Hadoop tidak menyediakan alat yang komprehensif untuk manajemen data, metadata, dan tata kelola data. Selain itu, ia kurang alat yang diperlukan untuk standarisasi data dan menentukan kualitas. - Kesenjangan bakat
Karena kurva pembelajaran Hadoop yang tajam, sulit menemukan programmer level awal dengan keterampilan Java yang cukup untuk produktif dengan MapReduce. Intensivitas ini adalah alasan utama penyedia tertarik untuk menempatkan teknologi basis data relasional (SQL) di atas Hadoop karena jauh lebih mudah menemukan programmer dengan pengetahuan yang baik dalam SQL daripada keterampilan MapReduce.
Administrasi Hadoop adalah seni dan ilmu, membutuhkan pengetahuan tingkat rendah tentang sistem operasi, perangkat keras, dan pengaturan kernel Hadoop. - Keamanan data
Protokol autentikasi Kerberos adalah langkah signifikan menuju pengamanan lingkungan Hadoop. Keamanan data sangat penting untuk melindungi sistem big data dari masalah keamanan data yang terpencil.
Kesimpulan
Hadoop sangat efektif dalam mengatasi pemrosesan big data saat diimplementasikan secara efektif dengan langkah-langkah yang diperlukan untuk mengatasi tantangannya. Ini adalah alat serbaguna untuk perusahaan yang berurusan dengan jumlah data yang besar.
Salah satu keuntungan utamanya adalah ia dapat berjalan pada perangkat keras apa pun dan kluster Hadoop dapat didistribusikan di ribuan server. Fleksibilitas seperti ini sangat penting dalam lingkungan infrastructure-as-code.



