Mengintegrasikan Akselerator Domain-Spesifik ke RISC-V untuk Beban Kerja AI, AR/VR, dan Vision
Saat ekosistem RISC-V pertama kali muncul, fokus utama adalah untuk mengurangi biaya dalam sistem terdalam yang sebelumnya mengandalkan arsitektur instruksi (ISA) CPU proprietary. Saat SoC bermigrasi ke proses FinFET, biaya mask yang tinggi mendorong banyak perancang untuk mengganti mesin keadaan terbatas dengan mikro-sequenser yang dapat diprogram yang dibangun pada ISA RISC-V. Perubahan ini memicu kegembiraan awal dan, dari 2014 hingga 2018, menyebabkan komoditisasi inti RISC-V yang ringan.
Saat arsitektur matang, RISC-V mendapatkan traksi dalam aplikasi waktu nyata dan kinerja tinggi—terutama sebagai front end untuk mesin akselerasi yang sangat spesialisasi untuk AI, AR/VR, dan visi komputer. Natur terbuka RISC-V memungkinkan perancang untuk memperluas ISA, memungkinkan prosesor untuk berkomunikasi dengan akselerator melalui antarmuka co-prosesor dengan latensi rendah daripada I/O terpeta memori tradisional.
Ekstensi vektor RISC-V lebih memberdayakan akselerator ini untuk memproses lapisan perantara dalam loop inti kernel. Namun, mencapai ini memerlukan ekstensi yang dibuat khusus, seperti instruksi muat kustom yang mentransfer data dari akselerator eksternal ke register vektor internal.
Aplikasi ini memerlukan model pemrograman yang menyeimbangkan efisiensi dengan fleksibilitas. Akselerator domain-spesifik—esensialmente array pengali besar—sangat efisien tetapi terbatas dalam operasi yang dapat dilakukan dan dalam kemampuan perpindahan data. Di sisi lain, CPU umum seperti x86 menawarkan fleksibilitas maksimal, tetapi sebagian besar desain tidak dapat menanggung budget daya >100 W yang diperlukan untuk keberagaman seperti itu.
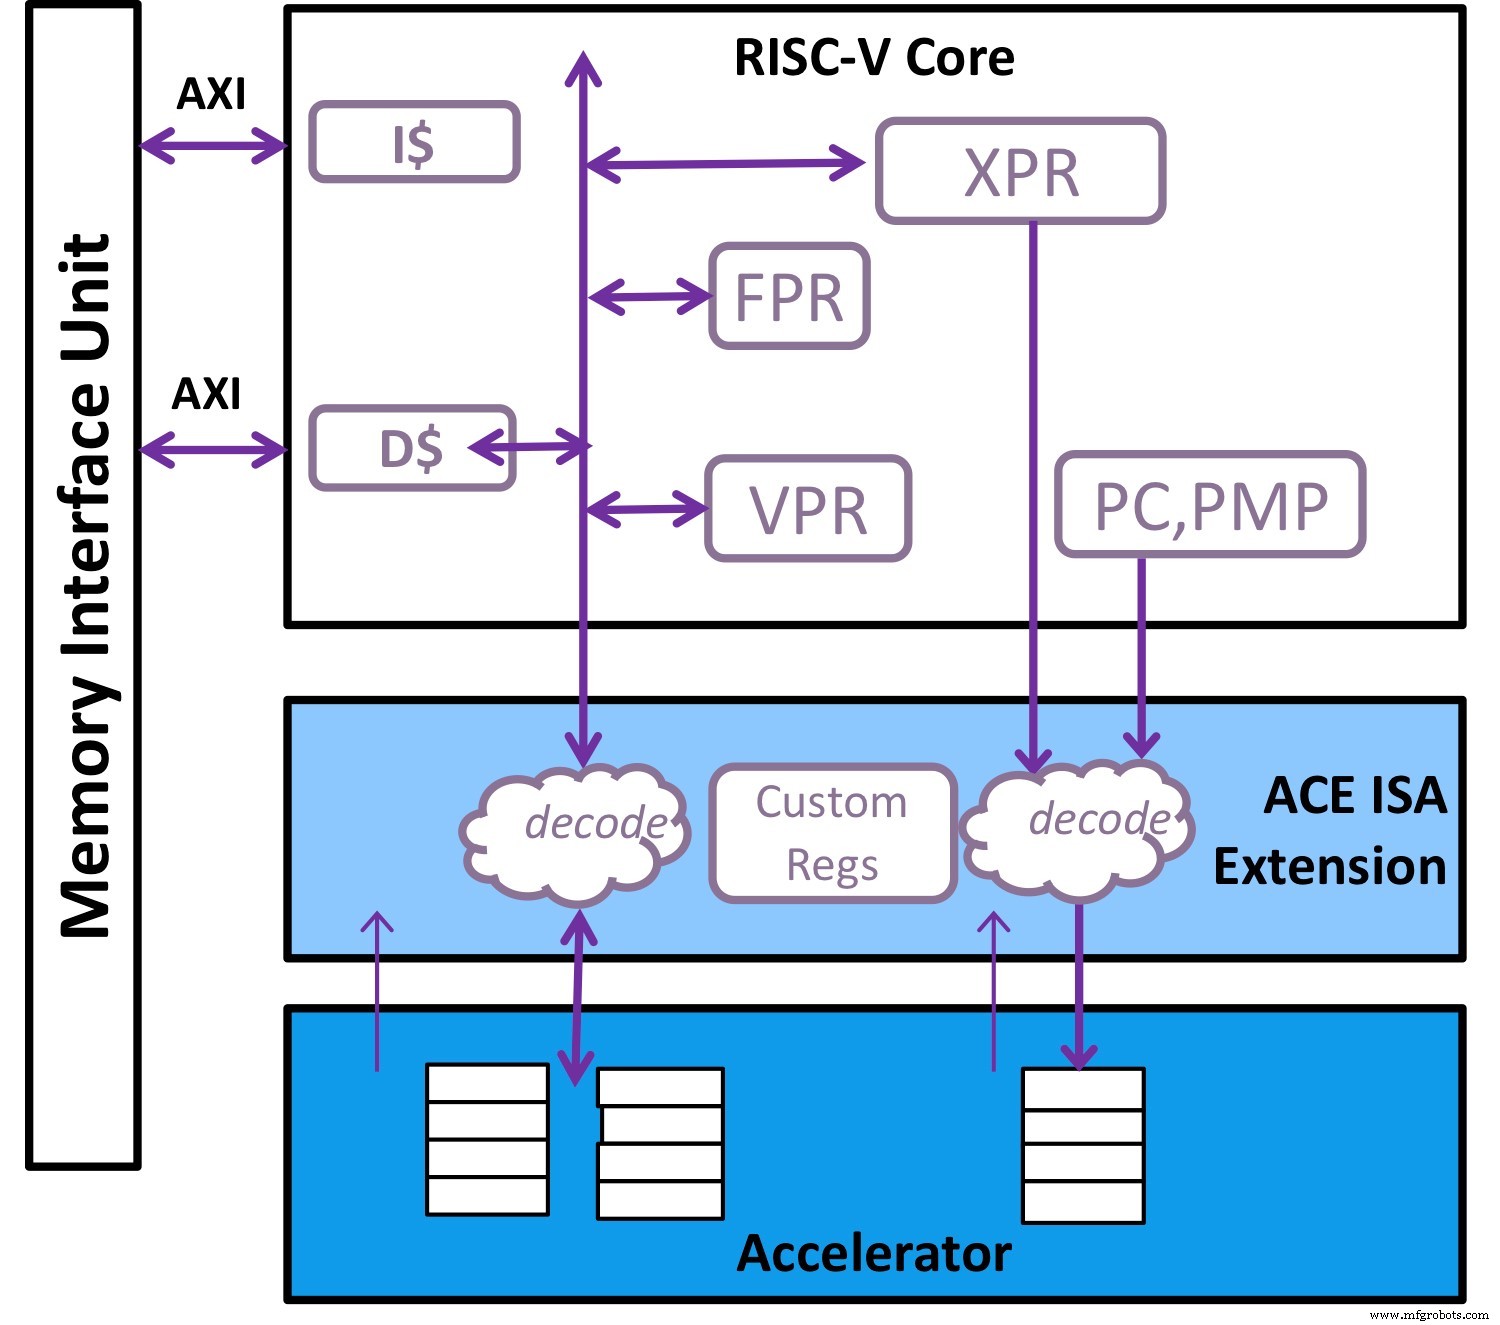
Ekstensi vektor standar RISC-V yang diperkaya dengan instruksi kustom spesial adalah teman ideal bagi akselerator (Gambar: Andes Technology)
Solusi optimal mencampur fleksibilitas CPU umum dengan akselerator spesifik tugas, seperti yang diilustrasikan di atas. Dalam RISC-V, ekstensi vektor standar yang matang—diperkaya dengan instruksi kustom yang disesuaikan—melayani sebagai mitra sempurna. Sinergi ini telah terlihat dalam 18 bulan terakhir, seiring solusi akselerasi domain-spesifik (DSA) berkonsentrasi pada platform RISC-V.
Untuk mengaktifkan visi ini, akselerator harus menjalankan set instruksi sendiri menggunakan sumber daya khususnya, termasuk memori. Inti RISC-V harus meratakan mikro-kode, memasukkan semua informasi kontrol yang diperlukan ke dalam satu instruksi. Set instruksi ini harus menyadari register skalar dan vektor prosesor, serta register kontrol dan memori milik akselerator sendiri.
Saat akselerator membutuhkan bantuan dengan pengurutan atau manipulasi data khusus, arsitektur Andes menggunakan unit pemrosesan vektor (VPU) untuk menangani permutasi kompleks—menggeser, mengumpulkan, mengompresi, dan memperluas. Antara lapisan, kernel sering melibatkan pola data yang rumit; VPU menyediakan fleksibilitas yang diperlukan. Dengan baik akselerator dan VPU menjalankan komputasi paralel massal, Andes telah memperkenalkan hardware untuk meningkatkan bandwidth subsistem memori—prefetching, transaksi non-blokir, dan pengembalian out-of-order—untuk memenuhi permintaan komputasi.
Prosesor vektor RISC-V pertama Andes Technology, NX27V, mengimplementasikan spesifikasi V-ekstensi terbaru 0.8. Ini mendukung operasi integer 8-, 16-, dan 32-bit, perhitungan floating-point 16- dan 32-bit, Bfloat16, dan format Int4 untuk mengurangi penyimpanan dan bandwidth transfer bobot pembelajaran mesin. Fleksibilitas spesifikasi vektor memungkinkan perancang mengonfigurasi parameter kunci—panjang vektor, bit per register, lebar SIMD, dan jumlah bit yang diproses per siklus.
NX27V menawarkan panjang vektor 512-bit yang dapat diperluas hingga 4096 bit dengan merantai hingga delapan register vektor. Beberapa unit fungsional beroperasi dalam pipeline paralel, mempertahankan throughput yang diperlukan oleh beban kerja yang beragam. Dalam konfigurasi 512-bit, chip mencapai 1 GHz dalam proses 7 nm dalam kondisi terburuk, menempati hanya 0,3 mm². Untuk pengembangan perangkat lunak, Andes menyediakan compiler, debugger, library vektor, simulator siklus, dan alat visualisasi Clarity untuk menganalisis dan mengoptimalkan loop kritis. Solusi ini sudah tersedia melalui program early-access.
Dalam 15 bulan terakhir, permintaan untuk komputasi kinerja tinggi—yang menggabungkan ekstensi vektor RISC-V yang kuat, subsistem memori bandwidth tinggi, dan akselerator yang ditempatkan dekat dengan CPU—telah melonjak. Tren ini diyakini akan mendorong adopsi yang lebih luas RISC-V dan pemrosesan vektor di seluruh industri.
>> Artikel ini awalnya diterbitkan di situs kawan kami, EE Times.