MLCommons Ungkap MLPerf Inference Benchmark 2024: Hasil Edge, Data Center, Mobile, dan Notebook
MLCommons, organisasi independen yang mengatur suite benchmark MLPerf, telah mengumumkan putaran terbaru dari skor MLPerf Inference. Hasil baru ini dibagi dengan rapi menjadi empat kelas perangkat—data center, edge, mobile, dan notebook—yang membuatnya lebih mudah bagi pembeli, vendor, dan peneliti untuk membandingkan performa di seluruh beban kerja dunia nyata.
Segmentasi Kelas Perangkat
Memisahkan skor berdasarkan kelas perangkat mencerminkan faktor bentuk dan profil performa yang berbeda yang memfaktori setiap pasar. Seperti yang dikatakan David Kanter, direktur eksekutif MLCommons kepada EE Times, “Jika Anda berbicara tentang notebook, kemungkinan besar berjalan di Windows; jika Anda berbicara tentang smartphone, Anda mungkin berjalan di iOS atau Android.” Dengan mengisolasi hasil mobile dan notebook, benchmark memberikan wawasan yang lebih jelas tentang kemampuan akselerator paling relevan untuk setiap kasus penggunaan.
Model Terkini
Berbeda dengan putaran sebelumnya yang difokuskan terutama pada tugas visi, benchmark saat ini mengintegrasikan lima model modern, berkualitas produksi:
DLRM – mesin rekomendasi skala besar
3D-UNet – model citra medis untuk deteksi tumor dalam scan MRI
RNN-T – mesin ucapan-ke-teks
BERT – transformer pemrosesan bahasa alami
MobileNetEdge, SSD-MobileNetv2, Deeplabv3, dan Mobile BERT – varian yang dioptimalkan mobile dari di atas
Pilihan ini didorong oleh dewan pengawas yang mencakup pakar industri dari domain rekomendasi, citra medis, dan ucapan, memastikan benchmark mencerminkan beban kerja paling menuntut dalam produksi saat ini.
Performa Data Center
Seperti yang diantisipasi, GPU Nvidia mendominasi kelas data center. Faktanya, 85% dari total pengiriman didukung oleh hardware Nvidia, dan perusahaan itu meraih setiap kategori yang diikutinya. Benchmark menunjukkan semakin lebarnya kesenjangan performa: pada model visi komputer dasar, Nvidia A100 memberikan sekitar 30× throughput dari CPU Intel Cooper Lake, dan 237× lebih cepat dari CPU yang sebanding pada beban kerja sistem rekomendasi. Paresh Kharya, senior director manajemen produk Nvidia, menyoroti bahwa satu DGX-A100 dapat mencocokkan performa klaster CPU 1.000 node untuk tugas rekomendasi, menawarkan nilai besar untuk skala.
Peserta non-CPU, non-GPU tunggal dalam kelas ini adalah Mipsology’s Zebra accelerator, yang berjalan pada FPGA Xilinx Alveo U250. Zebra mencapai 4.096 kueri ResNet per detik dalam mode server versus 5.563 untuk Nvidia T4, dan 5.011 sampel per detik offline dibandingkan 6.112 untuk T4.
Dalam kategori penelitian dan pengembangan, perusahaan Taiwan Neuchips’ RecAccel—akselerator berbasis FPGA untuk DLRM—melakukan pada par dengan atau di bawah CPU Intel Cooper Lake dan ketinggalan dari hasil Nvidia. Prototipe tahap awal ini menunjukkan lebar hardware AI yang muncul, meskipun belum tersedia secara komersial.
Hasil Tingkat Edge
Sistem edge sebagian besar didukung oleh chip Nvidia A100, T4, AGX Xavier, dan Xavier NX. Desain referensi Centaur Technology, yang menampilkan prosesor x86 proprietary dan koprosesor AI terpisah, mengalahkan Nvidia Tesla T4 dalam latensi ResNet single-stream tetapi ketinggalan pada throughput. Konsultan Inggris dividiti menyajikan berbagai skor—dari Raspberry Pi hingga Nvidia AGX Xavier—yang menyoroti bagaimana pilihan sistem operasi dan penggunaan akselerator on-chip dapat mempengaruhi hasil.
Peserta baru dari kelompok penelitian dan pengembangan termasuk perusahaan Rusia IVA Technologies dan startup Korea Mobilint. Meskipun keduanya tidak mencapai performa terobaan, inklusi mereka menunjukkan bahwa prototipe akselerator mencapai tingkat kematangan perangkat lunak yang layak untuk dibenchmark terhadap solusi komersial.
Benchmark Mobile dan Notebook
Kelas mobile melihat tiga pengiriman yang sebanding: MediaTek Dimensity 820 (di Xiaomi Redmi 10X 5G), Qualcomm Snapdragon 865+ (diuji pada Asus ROG Phone 3), dan Samsung Exynos 990 (digunakan di Galaxy Note 20 Ultra). Samsung unggul dalam klasifikasi citra dan NLP, MediaTek unggul dalam deteksi objek, dan Samsung lagi unggul dalam segmentasi citra. Hasil ini menggambarkan bahwa tidak ada SoC tunggal yang mendominasi di semua tugas, menekankan pentingnya optimisasi spesifik beban kerja.
Kategori notebook mengandung satu desain referensi Intel yang menampilkan GPU Xe-LP mendatang. Meskipun set data yang terbatas membuat perbandingan detail sulit, Xe-LP mencapai 2,5× throughput yang lebih tinggi dari SoC mobile terbaik pada segmentasi citra (DeeplabV3) dan 1,15× lebih baik pada deteksi objek (SSD-MobileNetv2).
Menatap Masa Depan
Kanter menekankan komitmen MLCommons terhadap keragaman dalam ekosistem benchmark. Organisasi mendorong partisipasi non-Nvidia, non-Intel, dan perusahaan kecil, dengan divisi terbuka yang memungkinkan jaringan atau model apa pun untuk diuji. “Kami juga sedang menambahkan dimensi pengukuran daya untuk putaran berikutnya,” kata Kanter, mengajak komunitas untuk membantu mengembangkan alat yang diperlukan.
Untuk daftar lengkap dan detail hasil MLPerf Inference, klik di sini.
Sumber: EE Times
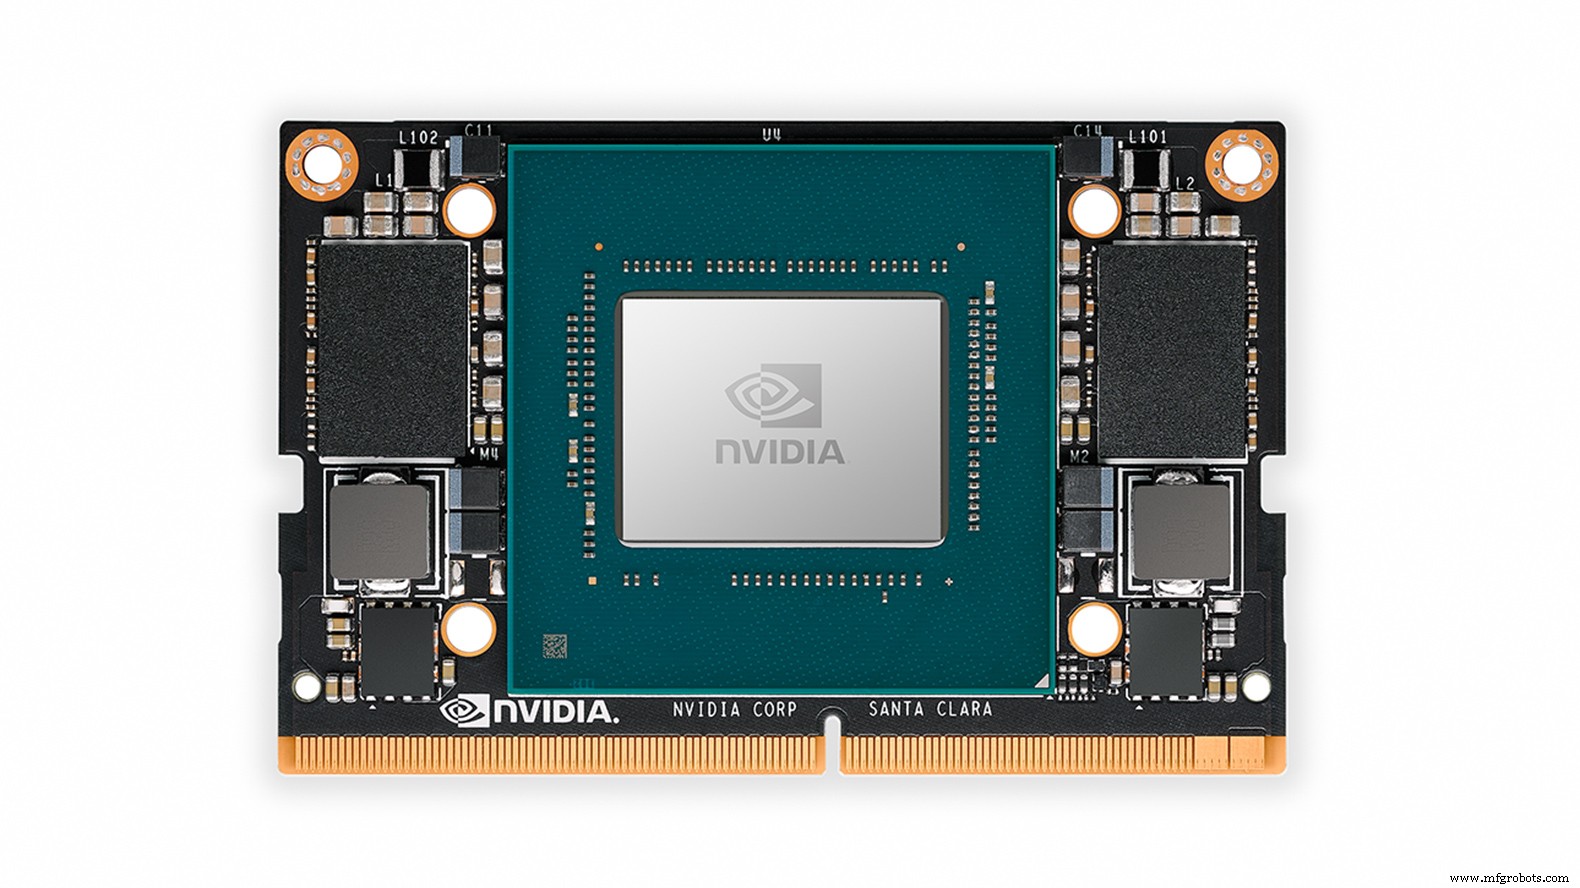
Hasil edge didominasi GPU Nvidia, termasuk Jetson Xavier NX