Dalam beberapa tahun terakhir, terobosan dalam pengenalan ucara otomatis (ASR) telah mengubah suara dari keajaiban menjadi antarmuka utama untuk banyak perangkat. IEEE Spectrum menyebut 2017 sebagai “tahun pengenalan suara,” dan ZDNet melaporkan di CES bahwa suara adalah antarmuka komputer berikutnya. Berikut ini adalah garis besar ekosistem suara saat ini dan teknologi yang mendukungnya.
Berapa banyak perangkat Anda yang bicara dengan Anda? Aktivasi suara kini sudah umum. Setiap smartphone flagship—iPhone 7, Galaxy S7—dilengkapi dengan asisten suara yang selalu aktif, begitu juga dengan jam tangan pintar, wearable, dan hearables seperti Apple AirPods dan Samsung Gear IconX. Banyak perangkat tidak memiliki UI tradisional, sehingga suara adalah cara praktis untuk berinteraksi. Kamera baru (misalnya, GoPro Hero 5) menerima perintah suara untuk selfie bebas tangan, dan sistem infotainment mobil telah membuat audio dikontrol suara menjadi norma untuk berkendara lebih aman.
Amazon Echo memicu boom asisten percakapan. Alexa, layanan suara Amazon, dilengkapi dengan ratusan keterampilan bawaan—lelucon, skor olahraga, kuis film—dan berbagai Easter egg. Pengembang dapat memperluas kemampuan Alexa dengan Alexa Skills Kit (ASK). Misalnya, seorang hobiis mengubah iRobot Roomba menjadi vacum dikontrol suara dengan membuat keterampilan khusus. Alexa juga mendukung layanan praktis seperti memesan makanan, memesan perjalanan, dan mengontrol perangkat rumah pintar dari Whirlpool, GE, dan lainnya.
Amazon masih memimpin pasar, tetapi pesaen semakin mengejar. Facebook mengangkat Morgan Freeman sebagai suara asisten AI-nya, yang dibangun oleh Zuckerberg selama satu tahun dan dinamakan “Jarvis.” Sistem ini dapat mengidentifikasi pengguna berdasarkan suara, mengenali wajah, dan memberikan akses aman ke rumah. Di Jepang, Gatebox menawarkan asisten holografik bernama Azuma Hikari, yang menggabungkan speaker, proyektor, kamera, dan sensor gerakan untuk menciptakan pengalaman yang lebih imersif.
Bagaimana pickup suara far-field bekerja? Memahami perintah yang diucapkan saat musik latar berdengarkan—atau di seluruh ruangan—memerlukan beberapa teknologi canggih:
Deep learning menjadi daya dukung ASR modern. Jaringan saraf yang dilatih pada kumpulan data massal kini mencapai atau melebihi kinerja manusia dalam pengenalan ucara dan visual. Setelah dilatih, model berjalan secara real-time pada hardware perangkat.
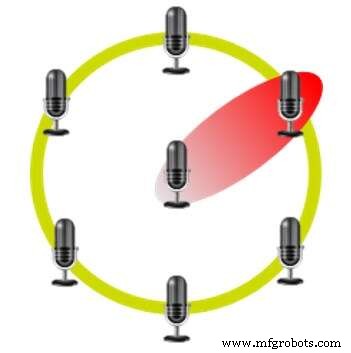
Adaptive beamforming meningkatkan keandalan dengan fokus pada arah pembicara. Perangkat seperti Echo menggunakan array mikrofon heksagonal (tujuh mikrofone) untuk mendeteksi waktu kedatangan sinyal, melacak pembicara yang Bergerak, dan memisahkan beberapa suara.
Beamforming menggunakan array mikrofon heksagonal (Sumber: CEVA)
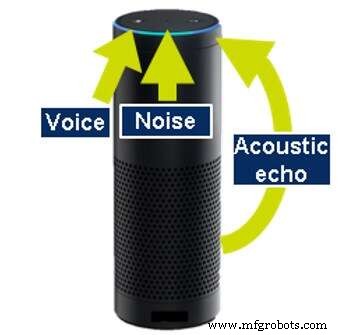
Acoustic echo cancellation menghilangkan audio sendiri perangkat (musik, respons yang diucapkan) sehingga tetap dapat mendengarkan perintah pengguna. Sistem memodelkan suara yang dihasilkan, baik dengan menganalisis data output atau menggunakan mikrofon khusus, dan menguranginya dari sinyal masuk. Ini memungkinkan pengguna untuk mengganggu (“barge‑in”) bahkan saat musik diputar.
Acoustic echo cancellation (Sumber: CEVA)
Teknik pengurangan echo tambahan, seperti dereverberation, memfilter refleksi tidak terduakan dari dinding dan permukaan lain, memastikan mesin ASR menerima sampel suara yang bersih.
Antarmuka suara saat ini masih berkembang Sementara 2017 menandai tonggak penting dalam adopsi suara, banyak tantangan masih ada—latensi, kesadaran konteks, dukungan multi-pembicara, dan privasi. Saya akan mengeksplorasi kekurangan ini dalam posting mendatang, jadi tunggu.
Eran Belaish adalah Product Marketing Manager untuk portofolio audio dan suara CEVA, mengembangkan solusi dari pemicu suara hingga audio nirkabel. Saat tidak terlibat dalam teknologi suara, ia menikmati freediving di dunia bawah air yang sunyi.