Membangun Autoencoder Variasional dengan TensorFlow: Panduan Praktis
Kuasai dasar-dasar autoencoder, temukan bagaimana autoencoder variasional meningkatkannya, dan ikuti implementasi TensorFlow langkah demi langkah.
Kecerdasan buatan telah mengubah banyak sektor, dan kompresi data bukan merupakan pengecualian. Autoencoder—terutama variannya yang variasional—menyediakan skema kompresi generatif yang kuat yang efisien dan ekspresif. Panduan ini membagi konsep inti dan memandu Anda melalui implementasi TensorFlow lengkap menggunakan dataset MNIST.
Aplikasi Autoencoder
Autoencoder luas digunakan di bidang yang bervariasi dari terjemahan mesin saraf hingga penemuan obat, denoising citra, dan deteksi anomali. Kemampuan mereka untuk mempelajari representasi terkompresi yang informatif menjadikannya alat pilihan untuk pipeline ML modern.
Komponen Kunci dari Autoencoder
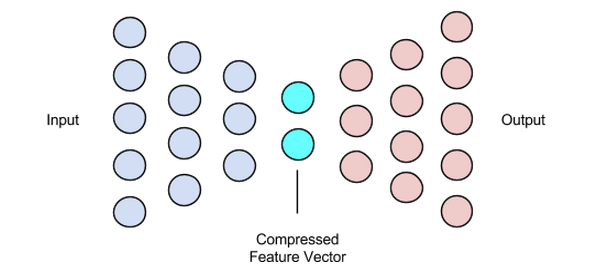
Berbeda dengan jaringan saraf biasa, autoencoder memiliki bottleneck yang memaksa representasi latent berdimensi rendah. Arsitektur terdiri dari tiga bagian utama:
- Encoder – mengompresi data input menjadi vektor latent.
- Bottleneck (Vektor Latent) – menyimpan fitur paling salient.
- Decoder – merekonstruksi input dari vektor latent.
Encoder dan decoder biasanya adalah jaringan feed-forward, tetapi varian spesial—konvolusional untuk citra, rekuren untuk teks—umum dalam praktik.
Encoder
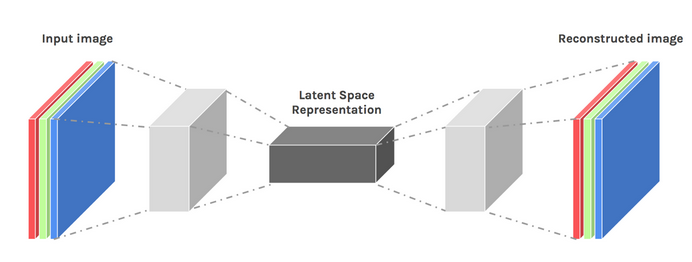
Encoder memetakan input berdimensi tinggi (misalnya, citra piksel 28×28) ke vektor latent yang kompak. Saat pelatihan, ia mengoptimalkan bobotnya sehingga vektor latent menangkap informasi penting, memungkinkan decoder untuk merekonstruksi input dengan kehilangan minimal.
Bottleneck (Vektor Latent)
Ukuran vektor latent adalah trade-off: terlalu kecil dan Anda kehilangan detail kritis; terlalu besar dan Anda mengurangi kompresi serta menambah komputasi. Memilih dimensi yang sesuai sangat penting untuk performa model.
Decoder
Decoder adalah cerminan encoder, mentransformasi vektor latent kembali ke ruang data asli. Biasanya menggunakan lapisan konvolusi transpos atau upsampling untuk memulihkan resolusi spasial.
Melatih Autoencoder
Autoencoder dilatih end-to-end menggunakan optimizer berbasis gradien seperti Adam. Tujuan adalah untuk meminimalkan loss rekonstruksi yang mengukur ketidaksesuaian antara input dan rekonstruksinya.
Fungsi Loss
Pilihan umum meliputi L1, L2, dan mean squared error (MSE). Setiap satu mengukur seberapa dekat output dengan input, menjadikannya cocok untuk tugas rekonstruksi generatif.
Variasi Jaringan
Meskipun multi-layer perceptron (MLP) dapat berfungsi sebagai encoder/decoder, jaringan saraf konvolusi (CNN) lebih disukai untuk data citra karena kesadaran spasialnya. Jaringan rekuren unggul dengan data sekensial seperti teks.
Autoencoder standar tidak memiliki kreativitas—mereka hanya dapat mereproduksi data yang telah dilihat selama pelatihan. Memperkenalkan stokastisitas melalui kerangka variasional membuka kemampuan generatif.
Autoencoder Variasional (VAE)
VAE memodifikasi arsitektur standar dengan dua cara:
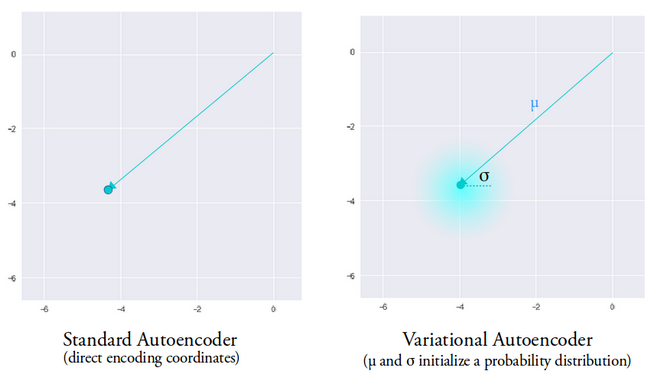
- Encoder mengeluarkan vektor mean dan vektor variansi, yang mendefinisikan distribusi Gaussian.
- Syarat divergensi Kullback-Leibler (KL) ditambahkan ke loss untuk meregulasi distribusi latent menuju Gaussian satuan.
Selama inferensi, encoder mengambil sampel vektor latent dari distribsi yang dipelajari, memungkinkan decoder untuk menghasilkan rekonstruksi yang beragam dan realistis. Stokastisitas ini mengurangi diskontinuitas yang sering diamati dalam autoencoder deterministik.
Implementasi TensorFlow
Di bawah ini adalah implementasi TensorFlow yang ringkas dan siap produksi dari konvolusi VAE yang dilatih pada MNIST.
Persiapan Data
(train_images, _), (test_images, _) = tf.keras.datasets.mnist.load_data() train_images = train_images.reshape(-1, 28, 28, 1).astype('float32') test_images = test_images.reshape(-1, 28, 28, 1).astype('float32') train_images /= 255. test_images /= 255. train_images[train_images >= .5] = 1. train_images[train_images < .5] = 0. test_images[test_images >= .5] = 1. test_images[test_images < .5] = 0. TRAIN_BUF = 60000 BATCH_SIZE = 100 TEST_BUF = 10000 train_dataset = tf.data.Dataset.from_tensor_slices(train_images).shuffle(TRAIN_BUF).batch(BATCH_SIZE) test_dataset = tf.data.Dataset.from_tensor_slices(test_images).shuffle(TEST_BUF).batch(BATCH_SIZE)
Definisi Model VAE
class CVAE(tf.keras.Model): def __init__(self, latent_dim): super(CVAE, self).__init__() self.latent_dim = latent_dim self.inference_net = tf.keras.Sequential([ tf.keras.layers.InputLayer(input_shape=(28, 28, 1)), tf.keras.layers.Conv2D(32, 3, strides=2, activation='relu'), tf.keras.layers.Conv2D(64, 3, strides=2, activation='relu'), tf.keras.layers.Flatten(), tf.keras.layers.Dense(latent_dim + latent_dim), # mean & logvar ]) self.generative_net = tf.keras.Sequential([ tf.keras.layers.InputLayer(input_shape=(latent_dim,)), tf.keras.layers.Dense(7*7*32, activation='relu'), tf.keras.layers.Reshape((7, 7, 32)), tf.keras.layers.Conv2DTranspose(64, 3, strides=2, padding='SAME', activation='relu'), tf.keras.layers.Conv2DTranspose(32, 3, strides=2, padding='SAME', activation='relu'), tf.keras.layers.Conv2DTranspose(1, 3, padding='SAME'), # logits ]) @tf.function def sample(self, eps=None): if eps is None: eps = tf.random.normal(shape=(100, self.latent_dim)) return self.decode(eps, apply_sigmoid=True) def encode(self, x): mean, logvar = tf.split(self.inference_net(x), num_or_size_splits=2, axis=1) return mean, logvar def reparameterize(self, mean, logvar): eps = tf.random.normal(shape=mean.shape) return eps * tf.exp(logvar * .5) + mean def decode(self, z, apply_sigmoid=False): logits = self.generative_net(z) if apply_sigmoid: return tf.sigmoid(logits) return logits
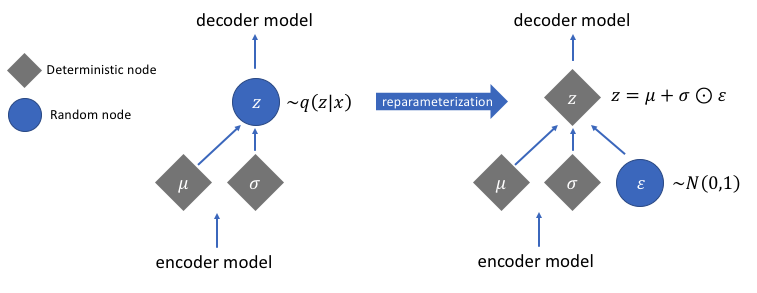
Fungsi pembantu kunci—encode, reparameterize, dan decode—mengenkapsulasi alur kerja VAE. Metode reparameterize mengimplementasikan trik reparameterisasi, memungkinkan aliran gradien melalui sampling stokastik.
Trik Reparameterisasi
Mengambil sampel vektor latent langsung dari distribusi merusak diferensialitas. Dengan mengekspresikan sampel sebagai z = mean + std * eps di mana eps ~ N(0,1), gradien menyebar melalui mean dan std. Syarat divergensi KL lebih menyelaraskan distribusi yang dipelajari dengan normal standar, mempromosikan ruang latent yang halus.
Ringkasan Cepat Langkah-langkah
- Definisikan arsitektur encoder dan decoder.
- Implementasikan trik reparameterisasi untuk mengaktifkan back-propagation.
- Latih model end-to-end, meminimalkan loss rekonstruksi ditambah divergensi KL.
Untuk kode lengkap dan skrip pelatihan tambahan, kunjungi tutorial resmi TensorFlow.
Kredit gambar: Chiman Kwan (dimodifikasi)



