Minima Lokal dalam Pelatihan Jaringan Syaraf Tiruan: Mitos atau Realitas?
Memahami peran minima lokal dalam pelatihan perceptron dan jaringan saraf tiruan lapisan ganda.
Dalam seri jaringan saraf tiruan AAC, kami telah memeriksa banyak aspek desain dan pelatihan perceptron lapisan ganda. Sebelum menyelami minima lokal, tinjau postingan sebelumnya:
- Bagaimana Melakukan Klasifikasi Menggunakan Jaringan Saraf Tiruan: Apa Itu Perceptron?
- Bagaimana Menggunakan Contoh Perceptron Jaringan Saraf Tiruan Sederhana untuk Mengklasifikasikan Data
- Bagaimana Melatih Perceptron Jaringan Saraf Tiruan Dasar
- Memahami Pelatihan Jaringan Saraf Tiruan Sederhana
- Pengantar Teori Pelatihan untuk Jaringan Saraf Tiruan
- Memahami Learning Rate dalam Jaringan Saraf Tiruan
- Machine Learning Tingkat Lanjut dengan Perceptron Lapisan Ganda
- Fungsi Aktivasi Sigmoid: Aktivasi dalam Jaringan Saraf Tiruan Perceptron Lapisan Ganda
- Bagaimana Melatih Jaringan Saraf Tiruan Perceptron Lapisan Ganda
- Memahami Rumus Pelatihan dan Backpropagation untuk Perceptron Lapisan Ganda
- Arsitektur Jaringan Saraf Tiruan untuk Implementasi Python
- Bagaimana Membuat Jaringan Saraf Tiruan Perceptron Lapisan Ganda dalam Python
- Pemrosesan Sinyal Menggunakan Jaringan Saraf Tiruan: Validasi dalam Desain Jaringan Saraf Tiruan
- Dataset Pelatihan untuk Jaringan Saraf Tiruan: Bagaimana Melatih dan Memvalidasi Jaringan Saraf Tiruan Python
- Berapa Banyak Lapisan Tersembunyi dan Node Tersembunyi yang Dibutuhkan oleh Jaringan Saraf Tiruan?
- Bagaimana Meningkatkan Akurasi Jaringan Saraf Tiruan Lapisan Tersembunyi
- Mengintegrasikan Node Bias ke dalam Jaringan Saraf Tiruan Anda
- Memahami Minima Lokal dalam Pelatihan Jaringan Saraf Tiruan
Melatih jaringan saraf tiruan adalah tugas optimisasi yang canggih. Meskipun kita jarang perlu memahami setiap nuansa matematis untuk membangun model yang efektif, fenomena minima lokal tetap menjadi pertimbangan teoretis yang kritis.
Mengapa Minima Lokal Penting
Secara historis, minima lokal dianggap sebagai hambatan besar dalam pelatihan, terutama untuk pemetaan input-output yang kompleks. Penelitian terbaru—seperti studi tentang geometri permukaan loss (misalnya, Choromanska et al., 2015; Dauphin et al., 2014)—menunjukkan bahwa arsitektur modern dan heuristik pelatihan mengurangi keparahan masalah ini. Namun demikian, memahami minima lokal membantu kita menghargai bagaimana optimizer berbasis gradien menavigasi lanskap loss berdimensi tinggi dan mengapa strategi pelatihan tertentu dapat melarikan diri dari titik suboptimal.
Mendefinisikan Minimum Lokal
Pertimbangkan permukaan error kuadrat sederhana: f(x, y) = x² + y². Titik mana pun yang menghasilkan error terendah yang mungkin—disebut minimum global—adalah target pelatihan. Dalam mangkuk konveks sempurna, gradient descent akan selalu konvergen ke titik ini terlepas dari posisi awal.
Dalam praktiknya, permukaan loss jauh dari konveks. Mereka dapat berisi banyak lembah dan plat, seperti yang diilustrasikan di bawah ini:
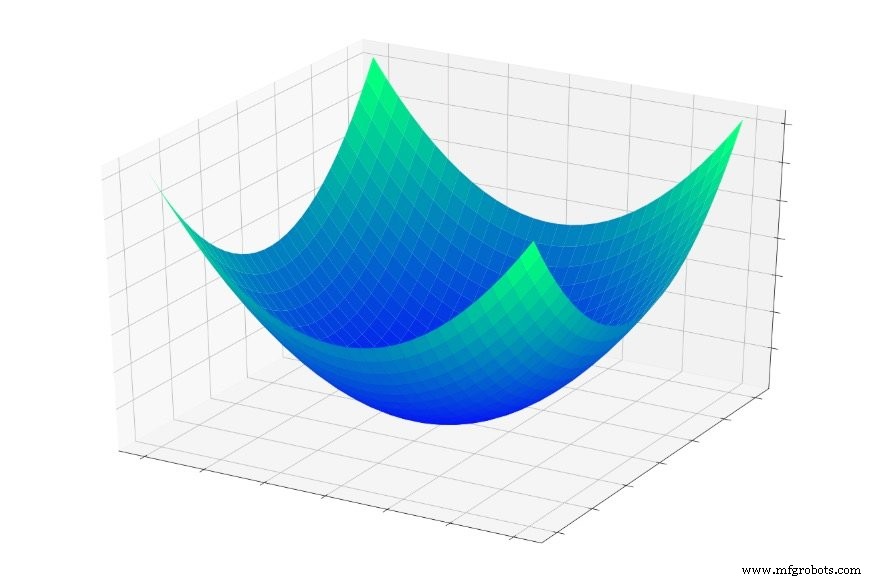
Ketika optimizer melangkah ke dalam rahang dangkal, ia mungkin menetap dalam minimum lokal—titik terendah dalam wilayah lokal tersebut—tetapi bukan yang global. Tanpa pengetahuan global, algoritma tidak dapat “mendaki” kembali untuk menjelajahi lembah yang lebih dalam.
Apakah Kami Benar-Benar Membutuhkan Minimum Global?
Sementara mencapai minimum global sering berkaitan dengan error pelatihan yang lebih rendah, ini tidak selalu menyamakan dengan generalisasi yang lebih baik. Jaringan saraf yang ekspresif tinggi yang mencapai pasokan sempurna pada data pelatihan dapat overfitting, mengurangi performa pada sampel yang belum terlihat. Dalam kasus tersebut, minimum lokal yang terletak dengan baik dapat memberikan solusi yang lebih andal. Selain itu, titik pelana—daerah datar di mana gradien hilang dalam beberapa arah—dapat menantang lebih besar dibandingkan minima lokal sederhana (Goodfellow et al., 2015).
Implikasi Praktis
Praktik pelatihan modern mengurangi efek minima lokal melalui teknik seperti stochastic gradient descent, jadwal learning rate, momentum, optimizer Adam, dan skema inisialisasi bobot. Metode ensemble dan regularisasi (dropout, L2) juga membantu model menghindari overfitting pada minimum global.
Kesimpulan
Minima lokal tetap menjadi aspek yang menarik dari pelatihan jaringan saraf tiruan. Memahami dampaknya memberikan informasi pada pilihan arsitektur, optimizer, dan strategi regularisasi. Dalam artikel berikutnya, kami akan menjelajahi teknik konkret—seperti annealing learning rate dan optimizer adaptif—yang mengarahkan jaringan menuju minimum yang diinginkan.



