Memanfaatkan DSP untuk Audio AI Real-Time di Edge
Memanfaatkan DSP untuk Audio AI Real-Time di Edge
Sekarang terbatas pada server cloud dengan sumber daya yang tak terbatas, machine learning sekarang bermigrasi ke perangkat edge. Latensi lebih rendah, biaya yang dikurangi, efisiensi energi, dan privasi yang ditingkatkan mendorong pergeseran ini. Misalnya, kendaraan otonom tidak dapat menunda waktu untuk mengirim data ke cloud untuk pengenalan pejalan kaki, dan biaya bandwidth dapat membuat pengenalan suara berbasis cloud melampaui batas.
Mengapa Pemrosesan Edge Penting
Trade-off energi antara transmisi data dan inferensi lokal adalah kritis. Beban kerja ML yang kompleks dapat menguras baterai perangkat jika tidak dieksekusi secara efisien. Inferensi edge juga menjaga data sensitif—seperti email yang dicoret melalui suara—pada perangkat, melindungi privasi pengguna.
Low-Power Always-On Voice Wake
Pendeteksi kata kunci (misalnya, “Hey Siri” atau “OK Google”) adalah salah satu kasus penggunaan edge-ML paling awal. Menjalankan deteksi tersebut pada prosesor aplikasi umum dapat mengonsumsi lebih dari 100 mW, dengan cepat menguras baterai smartphone. Ponsel awal memindahkan algoritma ke DSP kecil yang berjalan pada <5 mW, dan smart microphone modern sekarang melakukan tugas yang sama pada DSP audio-ML khusus pada <0.5 mW.
Di Luar Suara: Memperluas Kemampuan Edge
Sekali perangkat mendukung audio ML selalu nyala, ia dapat mengenali petunjuk kontekstual: restoran ramai, jalan sibuk, musik latar, tanda ultrasonik ruang, atau teriakan dan tawa di dekatnya. Fitur-fitur ini memungkinkan kasus penggunaan canggih yang memberikan manfaat baik pada perangkat maupun pengguna.
Membangun Edge AI DSP
Kinerja terbaik dan efisiensi energi untuk inferensi edge memerlukan perangkat keras yang disesuaikan. Teknik paling berdampak diringkas dalam tabel di bawah ini.
Tabel: Teknik Berdampak untuk Membuat Edge AI DSP 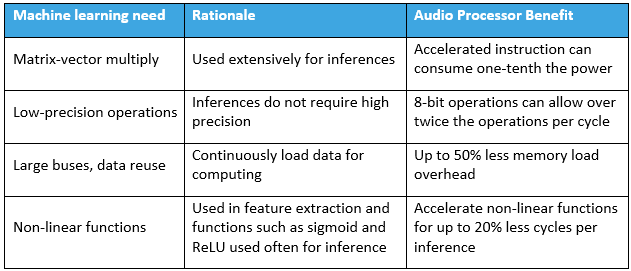
Inferensi jaringan saraf sangat bergantung pada perkalian matriks-vektor (MVM). Operasi fused multiply-accumulate (MAC) adalah tulang punggung eksekusi MVM yang efisien. Aritmetika presisi rendah—seringkali 8-bit—cukup untuk inferensi, secara drastis mengurangi kompleksitas komputasi. Intel dan Texas Instruments, misalnya, menawarkan prosesor dengan unit MAC presisi rendah khusus: TI TMS320C6745 mengeksekusi 8 MAC dari operand 8-bit per siklus, sementara DSP audio Knowles dapat melakukan 16 MAC semacam itu setiap siklus.
Kedua pelatihan dan inferensi membutuhkan bandwidth memori yang signifikan. Jalur data lebar mengurangi tekanan: AVX-512 Intel mendukung transfer 512-bit per siklus ke array 64-pengali; TI 6745 menggunakan bus 64-bit; prosesor Knowles menggunakan bus 128-bit, menyeimbangkan luas chip dan bandwidth. Arsitektur rekuren (RNN, LSTM) memerlukan loop umpan balik, yang mengenakan batasan arsitektur tambahan yang dapat menyebabkan desain terpipelined terhenti.
Pipeline audio-ML biasanya dimulai dengan analisis spektral dan ekstraksi fitur. Mempercepat operasi DSP klasik—FFT, filter, fungsi trigonometri dan logaritma—esensial untuk efisiensi energi. Operasi vektor non-linear (sigmoid, ReLU, dll.) juga mendapat manfaat dari instruksi satu siklus, lebih mengurangi jumlah siklus dan daya.
Singkatnya, prosesor yang menggabungkan percepatan machine learning dan sinyal audio memungkinkan inferensi selalu nyala real-time dengan biaya rendah sambil mempertahankan privasi. Pilihan arsitektur—set instruksi multi-operasi, bus lebar, dan unit presisi rendah khusus—mempertahankan kinerja tinggi tanpa daya tinggi. Saat komputasi edge khusus terus berevolusi, spektrum kasus penggunaan ML yang dapat diwujudkan akan meluas.
Jim Steele, Vice President of Technology Strategy, Knowles Corp.
© Artikel ini awalnya diterbitkan di EE Times: “Machine Learning on DSPs: Enabling Audio AI at the Edge.”



