Menambahkan Node Bias pada Perceptron Lapisan Ganda dengan Python
Artikel ini menjelaskan bagaimana mengintegrasikan node bias pada perceptron lapisan ganda (MLP) menggunakan Python, dan mengevaluasi efeknya pada performa klasifikasi.
Selamat datang di seri jaringan saraf tiruan All About Circuits, yang ditulis oleh Direktur Rekayasa Robert Keim. Jika Anda belum menjelajahi pelajaran lainnya, Anda akan menemukannya di bawah ini. Mereka memberikan dasar yang kuat untuk memahami konsep yang dibahas dalam postingan ini.
- Bagaimana Melakukan Klasifikasi Menggunakan Jaringan Saraf Tiruan: Apa Itu Perceptron?
- Bagaimana Menggunakan Contoh Perceptron Jaringan Saraf Tiruan Sederhana untuk Mengklasifikasikan Data
- Bagaimana Melatih Perceptron Jaringan Saraf Tiruan Dasar
- Memahami Pelatihan Jaringan Saraf Tiruan Sederhana
- Pengantar Teori Pelatihan untuk Jaringan Saraf Tiruan
- Memahami Learning Rate dalam Jaringan Saraf Tiruan
- Machine Learning Tingkat Lanjut dengan Perceptron Lapisan Ganda
- Fungsi Aktivasi Sigmoid: Aktivasi dalam Jaringan Saraf Tiruan Perceptron Lapisan Ganda
- Bagaimana Melatih Jaringan Saraf Tiruan Perceptron Lapisan Ganda
- Memahami Rumus Pelatihan dan Backpropagation untuk Perceptron Lapisan Ganda
- Arsitektur Jaringan Saraf Tiruan untuk Implementasi Python
- Bagaimana Membuat Jaringan Saraf Tiruan Perceptron Lapisan Ganda dalam Python
- Pemrosesan Sinyal Menggunakan Jaringan Saraf Tiruan: Validasi dalam Desain Jaringan Saraf Tiruan
- Dataset Pelatihan untuk Jaringan Saraf Tiruan: Bagaimana Melatih dan Memvalidasi Jaringan Saraf Tiruan Python
- Berapa Banyak Lapisan Tersembunyi dan Node Tersembunyi yang Dibutuhkan oleh Jaringan Saraf Tiruan?
- Bagaimana Meningkatkan Akurasi Jaringan Saraf Tiruan Lapisan Tersembunyi
- Mengintegrasikan Node Bias ke dalam Jaringan Saraf Tiruan Anda
Node bias adalah input tambahan yang menyediakan nilai konstan—biasanya +1—secara langsung ke input atau lapisan tersembunyi perceptron. Mereka memungkinkan jaringan untuk menggeser batas keputusan tanpa mengubah data input itu sendiri. Artikel ini menyajikan dua metode praktis untuk menambahkan node bias dan menunjukkan bagaimana menilai dampaknya pada akurasi model.
Metode 1: Menambahkan Bias melalui Spreadsheet
Ketika data pelatihan atau validasi Anda berada dalam spreadsheet, Anda dapat menyisipkan kolom bias tanpa menyentuh kode Python.
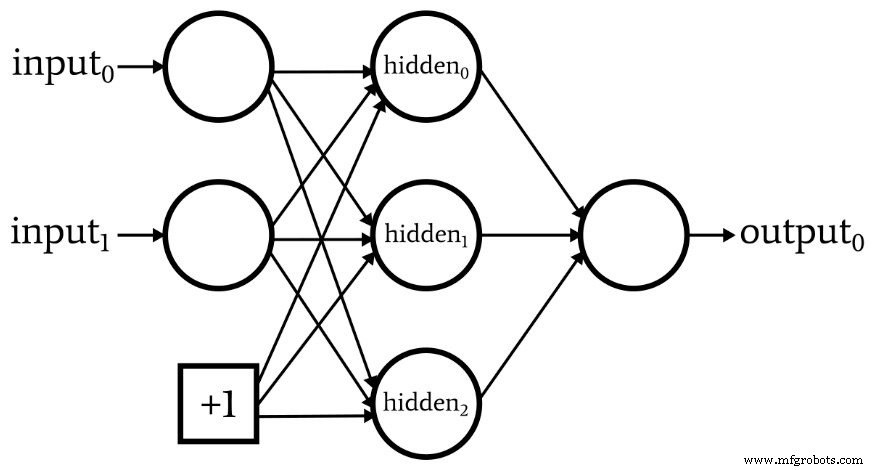
Langkah-langkah:
- Sisipkan kolom baru dalam spreadsheet dan isi dengan nilai bias yang diinginkan (biasanya +1).
- Sesuaikan dimensi lapisan input dalam kode Anda untuk meniru kolom baru.
Pendekatan ini cepat dan tidak memerlukan perubahan kode, menjadikannya ideal untuk prototyping.
Metode 2: Mengintegrasikan Bias Secara Langsung dalam Python
Untuk lebih fleksibel—seperti menambahkan bias pada lapisan tersembunyi—Anda akan memodifikasi arsitektur jaringan dalam kode. Di bawah ini adalah contoh singkat yang menambahkan node bias ke lapisan input dan tersembunyi.
Memperbarui Dimensi Lapisan Input
# Memuat data pelatihan training_data = np.array(...) # shape: (sampel, fitur) training_count = training_data.shape[0] # Menambahkan kolom +1 untuk bias input bias_column = np.ones((training_count, 1)) training_data = np.hstack((training_data, bias_column) # Ulangi untuk data validasi validation_data = np.hstack((validation_data, np.ones((validation_count, 1))))
Di sini, np.ones membuat kolom satu yang mewakili input bias konstan. Fungsi np.hstack kemudian menambahkan kolom ini ke matriks fitur yang ada.
Menambahkan Node Bias Lapisan Tersembunyi
# Selama komputasi feedforward for node in range(hidden_dim): # Hitung jumlah terbobot untuk setiap node tersembunyi z = np.dot(input_vector, weights_input_hidden[:, node]) post_activation[node] = activation_function(z) # Sisipkan nilai node bias (+1) ke dalam lapisan tersembunyi post_activation[hidden_dim] = 1.0 # Node bias di akhir
Ketika hidden_dim menyertakan node bias, loop berhenti sebelum node terakhir, dan nilai bias ditetapkan setelahnya. Sesuaikan loop validasi yang sesuai dengan cara yang sama.
Memilih Nilai Bias yang Berbeda
Meskipun +1 adalah konvensional, Anda dapat bereksperimen dengan konstanta lain. Untuk bias input, kalikan bias_column dengan nilai yang diinginkan. Untuk bias tersembunyi, modifikasi penugasan dalam loop feedforward sesuai kebutuhan.
Menilai Dampak Bias
Dalam Bagian 16 dari seri ini, MLP kesulitan mengklasifikasikan dataset eksperimen 3 yang kompleks tinggi. Untuk menentukan apakah node bias dapat membantu, kami melakukan sepuluh pelatihan independen dengan lapisan tersembunyi tujuh unit, membandingkan empat konfigurasi: tanpa bias, hanya bias input, hanya bias tersembunyi, dan keduanya.
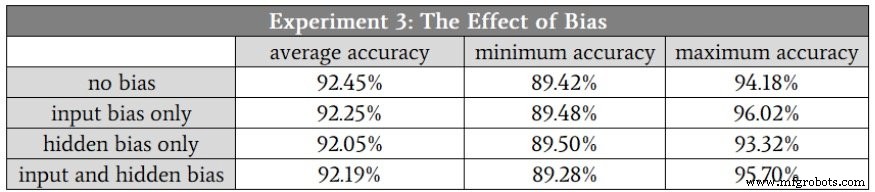
Hasilnya menunjukkan perbedaan minimal—node bias tidak secara signifikan meningkatkan akurasi untuk dataset tertentu ini. Hasil ini selaras dengan temuan dari studi lain yang menunjukkan bahwa node bias dapat bermanfaat dalam konteks tertentu tetapi bukan penguat performa universal.
Kesimpulan
Sementara node bias jarang mengubah akurasi klasifikasi dalam semua skenario, mereka tetap menjadi alat arsitektur yang berharga. Mengintegrasikan dukungan bias ke dalam basis kode Anda memastikan Anda dapat segera menguji efektivitasnya pada dataset atau varian model di masa depan. Dengan mengikuti metode yang diuraikan di atas, Anda dapat menambahkan node bias dengan usaha minimal dan mengevaluasi dampaknya secara sistematis.



