Mengoptimalkan Ukuran Lapisan Tersembunyi untuk Meningkatkan Akurasi Jaringan Syaraf Tiruan
Dalam artikel ini, kami akan melakukan eksperimen klasifikasi dan menganalisis bagaimana dimensi lapisan tersembunyi mempengaruhi performa jaringan syaraf tiruan.
Pelajari bagaimana menyesuaikan lapisan tersembunyi dalam Perceptron dapat meningkatkan akurasi, mengurangi waktu pelatihan, dan mempertahankan latensi yang dapat diterima—semua ditunjukkan dengan implementasi Python dan data set nyata.
Sebelum menyelami, tinjau postingan sebelumnya dalam seri jaringan syaraf tiruan kami untuk membangun dasar yang kokoh:
- Bagaimana Melakukan Klasifikasi Menggunakan Jaringan Syaraf Tiruan: Apa Itu Perceptron?
- Bagaimana Menggunakan Contoh Jaringan Syaraf Tiruan Perceptron Sederhana untuk Mengklasifikasikan Data
- Bagaimana Melatih Jaringan Syaraf Tiruan Perceptron Dasar
- Memahami Pelatihan Jaringan Syaraf Tiruan Sederhana
- Pengantar Teori Pelatihan untuk Jaringan Syaraf Tiruan
- Memahami Learning Rate dalam Jaringan Syaraf Tiruan
- Machine Learning Tingkat Lanjut dengan Perceptron Lapisan Ganda
- Fungsi Aktivasi Sigmoid: Aktivasi dalam Jaringan Syaraf Tiruan Perceptron Lapisan Ganda
- Bagaimana Melatih Jaringan Syaraf Tiruan Perceptron Lapisan Ganda
- Memahami Rumus Pelatihan dan Backpropagation untuk Perceptron Lapisan Ganda
- Arsitektur Jaringan Syaraf Tiruan untuk Implementasi Python
- Bagaimana Membuat Jaringan Syaraf Tiruan Perceptron Lapisan Ganda dalam Python
- Pemrosesan Sinyal Menggunakan Jaringan Syaraf Tiruan: Validasi dalam Desain Jaringan Syaraf Tiruan
- Dataset Pelatihan untuk Jaringan Syaraf Tiruan: Bagaimana Melatih dan Memvalidasi Jaringan Syaraf Tiruan Python
- Berapa Banyak Lapisan Tersembunyi dan Node Tersembunyi yang Dibutuhkan oleh Jaringan Syaraf Tiruan?
- Bagaimana Meningkatkan Akurasi Jaringan Syaraf Tiruan Lapisan Tersembunyi
Jumlah node dalam lapisan tersembunyi secara langsung mempengaruhi akurasi klasifikasi dan kecepatan pelatihan. Eksperimen kami akan memberikan intuisi berbasis data untuk memilih ukuran lapisan tersembunyi yang menyeimbangkan kecepatan, latensi, dan akurasi.
Benchmarking dalam Python
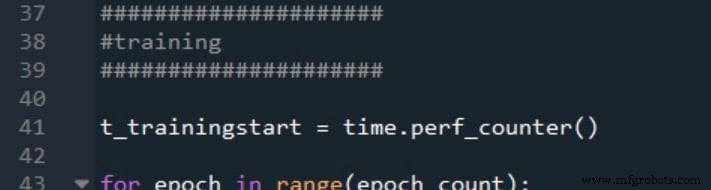
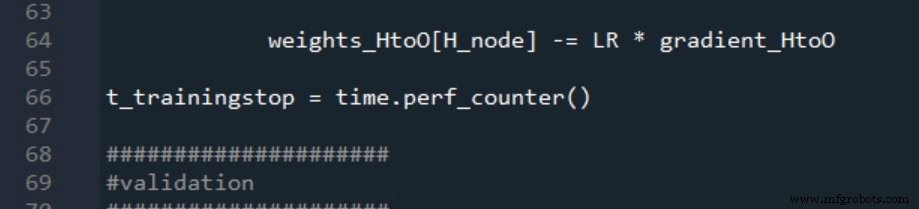
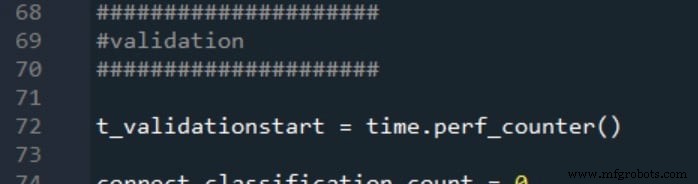
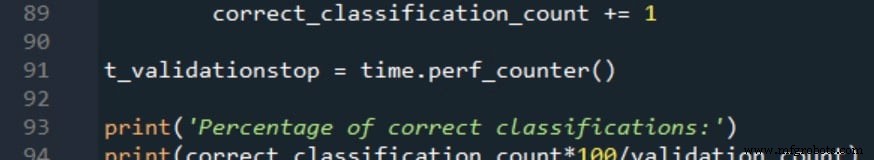
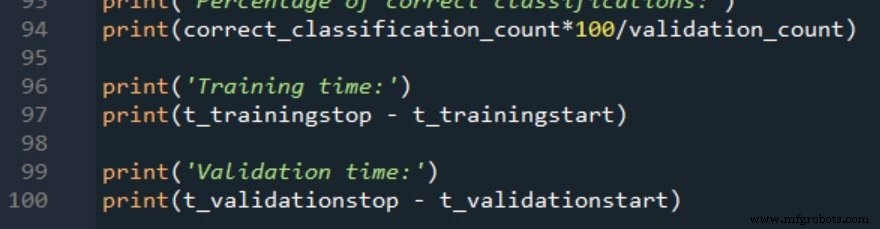
Kami akan menambahkan kode Python yang ada dari Bagian 12 untuk mencatat durasi pelatihan dan validasi menggunakan time.perf_counter(). Di bawah ini adalah instrumentasi waktu:
Waktu validasi mengikuti pola yang sama:
Hasilnya dilaporkan sebagai:
Data Pelatihan dan Prosedur Pengukuran
Kami menguji tugas klasifikasi biner menggunakan empat input numerik yang berkisar dari –20 hingga +20. Arsitektur jaringan adalah 4 node input, satu lapisan tersembunyi, dan satu node output. Nilai input dihasilkan dengan rumus Excel yang ditunjukkan di bawah ini:
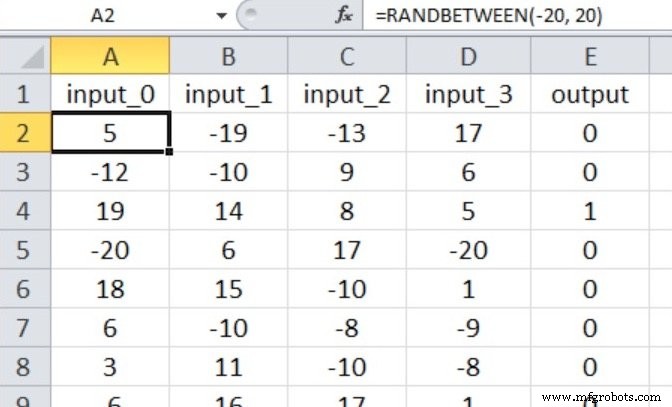
Ukuran dataset: 40.000 sampel pelatihan dan 5.000 sampel validasi. Kami menggunakan learning rate 0,1 dan melakukan satu epoch penuh per jalankan. Setiap dimensi lapisan tersembunyi diuji lima kali; akurasi dan waktu yang dilaporkan adalah rata-rata aritmatika.
Eksperimen 1: Masalah Kompleksitas Rendah
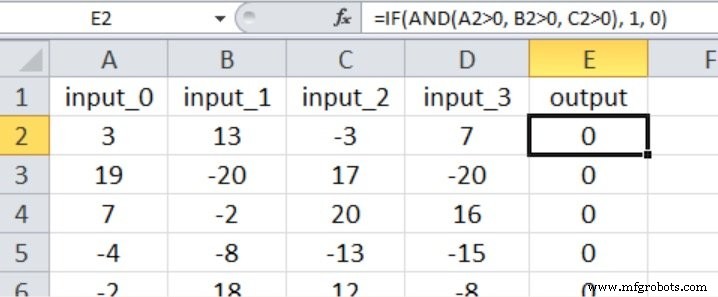
Target adalah benar hanya ketika tiga input pertama melebihi nol; input keempat tidak relevan:
Mengikuti pedoman dua-tiga dari ukuran input, kami memulai dengan H_dim = 2. Hasilnya diringkas di bawah ini:
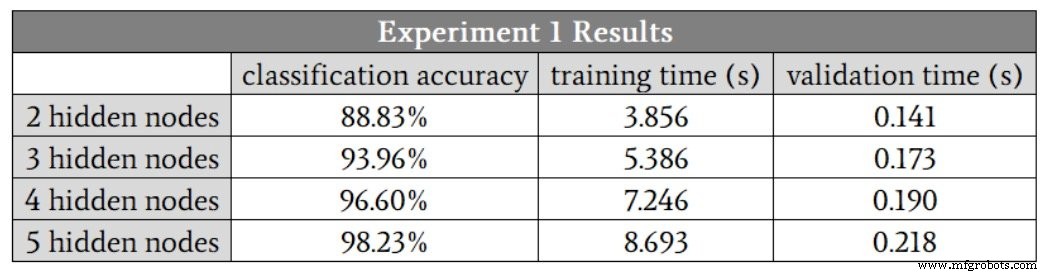
Akurasi meningkat hingga lima node tersembunyi, tetapi keuntungan tambahan dari empat ke lima node modest karena satu jalankan dengan empat node adalah outlier (88,6 %). Menghapus outlier tersebut menunjukkan empat node sedikit lebih baik daripada lima. Waktu pelatihan naik 1,9× dari dua ke empat node, sementara waktu validasi hanya naik 1,3×, yang menekankan bahwa pelatihan adalah fase yang lebih intensif komputasional.
Eksperimen 2: Masalah Kompleksitas Sederhana
Semua empat input mempengaruhi output, dengan perbandingan yang lebih halus:
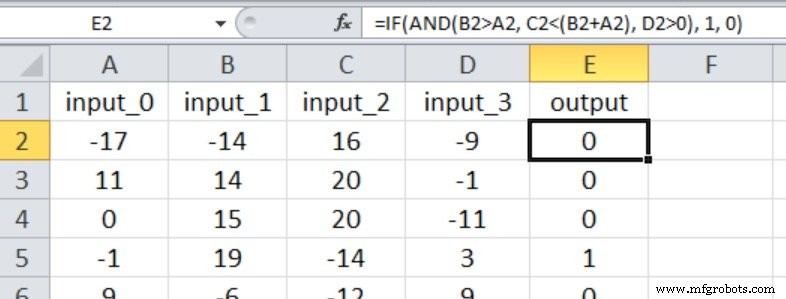
Memulai dengan tiga node tersembunyi, hasilnya adalah:
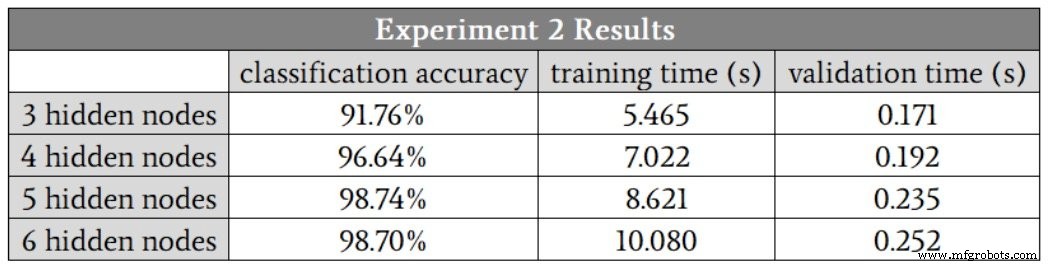
Di sini, lima node tersembunyi tampak optimal, menyeimbangkan akurasi dan kecepatan. Berbeda dengan Eksperimen 1, jalankan dengan lima dan enam node tidak menunjukkan outlier akurasi rendah, yang menunjukkan bahwa lapisan tersembunyi yang lebih besar memberikan ketahanan terhadap variasi pelatihan.
Eksperimen 3: Masalah Kompleksitas Tinggi
Skenario ini memperkenalkan nonlinearitas: satu input dikuadratkan, yang lain diakar:
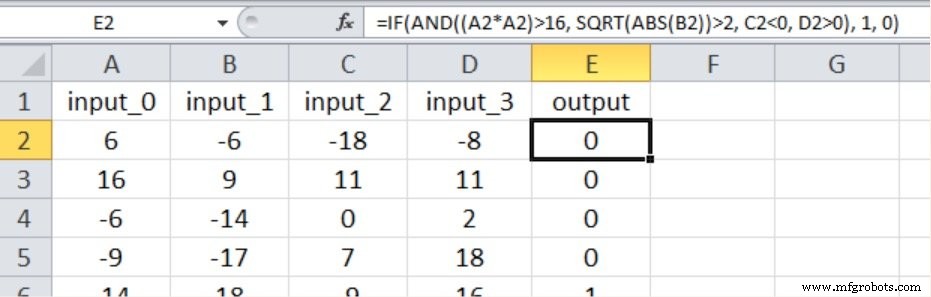
Hasilnya adalah sebagai berikut:
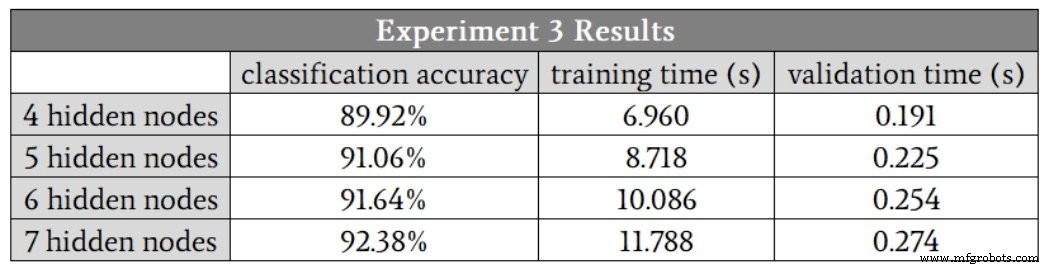
Akurasi menurun dibandingkan tugas kompleksitas lebih rendah, bahkan dengan tujuh node tersembunyi. Peningkatan seperti menambahkan istilah bias atau annealing learning rate dapat meningkatkan performa, tetapi hingga perubahan tersebut divalidasi, lapisan tersembunyi tujuh node direkomendasikan.
Kesimpulan
Eksperimen ini menggambarkan trade-off yang jelas: meningkatkan dimensi lapisan tersembunyi secara umum meningkatkan akurasi dan stabilitas dengan biaya waktu pelatihan yang lebih lama. Gunakan wawasan berbasis data di sini untuk member informasi pilihan desain Anda saat membangun klasifikasi berbasis Perceptron.



