Memilih Jumlah Lapisan dan Node Tersembunyi yang Tepat dalam Jaringan Syaraf Tiruan
Artikel ini menawarkan pedoman berbasis bukti untuk mengonfigurasi bagian tersembunyi dari Perceptron Lapisan Ganda.
Dalam postingan sebelumnya dari seri ini kami telah membahas jaringan Perceptron, arsitektur lapisan ganda, dan implementasi Python praktis. Sebelum memutuskan kedalaman dan lebar lapisan tersembunyi Anda, Anda mungkin ingin meninjau artikel dasar yang terdaftar di bawah ini.
- Bagaimana Melakukan Klasifikasi Menggunakan Jaringan Syaraf Tiruan: Apa Itu Perceptron?
- Bagaimana Menggunakan Contoh Jaringan Syaraf Tiruan Perceptron Sederhana untuk Mengklasifikasikan Data
- Bagaimana Melatih Jaringan Syaraf Tiruan Perceptron Dasar
- Memahami Pelatihan Jaringan Syaraf Tiruan Sederhana
- Pengantar Teori Pelatihan untuk Jaringan Syaraf Tiruan
- Memahami Learning Rate dalam Jaringan Syaraf Tiruan
- Machine Learning Tingkat Lanjut dengan Perceptron Lapisan Ganda
- Fungsi Aktivasi Sigmoid: Aktivasi dalam Jaringan Syaraf Tiruan Perceptron Lapisan Ganda
- Bagaimana Melatih Jaringan Syaraf Tiruan Perceptron Lapisan Ganda
- Memahami Rumus Pelatihan dan Backpropagation untuk Perceptron Lapisan Ganda
- Arsitektur Jaringan Syaraf Tiruan untuk Implementasi Python
- Bagaimana Membuat Jaringan Syaraf Tiruan Perceptron Lapisan Ganda dalam Python
- Pemrosesan Sinyal Menggunakan Jaringan Syaraf Tiruan: Validasi dalam Desain Jaringan Syaraf Tiruan
- Dataset Pelatihan untuk Jaringan Syaraf Tiruan: Bagaimana Melatih dan Memvalidasi Jaringan Syaraf Tiruan Python
- Memilih Jumlah Lapisan dan Node Tersembunyi yang Tepat dalam Jaringan Syaraf Tiruan
Rekap Lapisan Tersembunyi
Mari kita tinjau poin-poin kunci tentang node tersembunyi:
- Perceptron satu lapisan—jaringan yang hanya berisi node input dan output—terbatas pada masalah yang dapat dipisahkan secara linier. Mereka tidak dapat memodelkan hubungan kompleks seperti fungsi Boolean XOR.
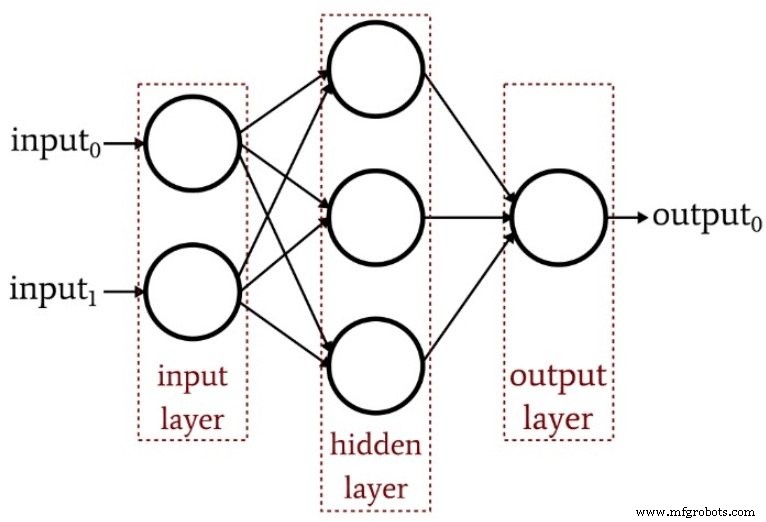
- Memperkenalkan lapisan tersembunyi mengubah Perceptron menjadi approximator universal, memungkinkannya untuk mempelajari hampir setiap pemetaan kontinu antara ruang input dan output yang terbatas.
- Bobot tersembunyi-ke-output mempengaruhi error akhir secara tidak langsung, sehingga pelatihan menjadi lebih rumit.
- Backpropagation adalah metode pelatihan standar: error dipropagasi kembali melalui jaringan, memungkinkan kita untuk memperbarui semua bobot non-output, terlepas dari jumlah lapisan tersembunyi.
Diagram di bawah ini mengilustrasikan struktur dasar dari Perceptron lapisan ganda.
Berapa Banyak Lapisan Tersembunyi?
Tidak ada jawaban yang cocok untuk semua. Namun, satu lapisan tersembunyi sudah memberikan jaringan kemampuan ekspresi yang luar biasa. Jika performa tidak memuaskan, pertimbangkan untuk menyesuaikan learning rate, memperpanjang epoch pelatihan, atau melengkapi dataset pelatihan sebelum menambahkan kedalaman.
Menambahkan lapisan tersembunyi kedua meningkatkan kompleksitas kode dan waktu inferensi, dan dapat memperburuk overfitting—terutama ketika data pelatihan terbatas.
Overfitting terjadi ketika jaringan menghafal idiosinkrasi dari dataset pelatihan alih-alih mempelajari pemetaan yang dapat digeneralisasi. Diagram berikut memvisualisasikan fenomena ini.
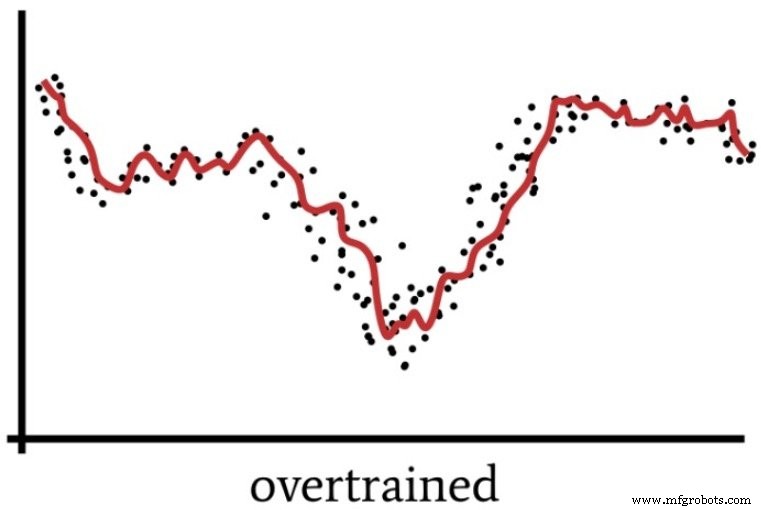
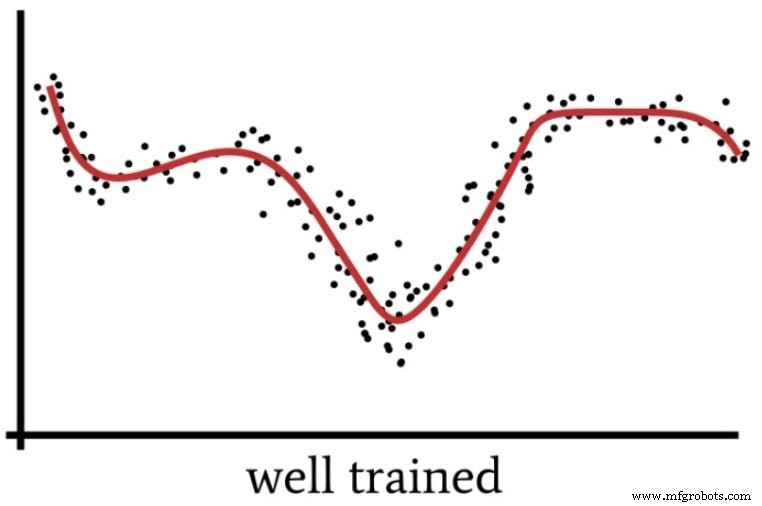
Jaringan yang sangat terparameterisasi mungkin “melakukan pemikiran berlebih” terhadap masalah, menghasilkan solusi yang berfungsi baik pada data pelatihan tetapi buruk pada sampel yang belum terlihat. Gambar berikut menunjukkan bagaimana kapasitas berlebih dapat menghambat generalisasi.
Kapan lapisan tersembunyi tambahan dipertaruhkan? Dr. Jeff Heaton, dalam bukunya yang komprehensif tentang pelatihan jaringan syaraf tiruan, mencatat bahwa satu lapisan tersembunyi dapat mendekati setiap fungsi kontinu antara ruang terbatas. Menambahkan lapisan kedua memungkinkan jaringan untuk merepresentasikan batas keputusan dengan akurasi sembarang, tetapi hanya ketika kompleksitas masalah benar-benar memerlukannya.
Berapa Banyak Node Tersembunyi?
Memilih jumlah node yang tepat per lapisan tersembunyi adalah keseimbangan antara ekspresivitas dan risiko overfitting. Sementara eksperimen adalah kunci, Dr. Heaton memberikan tiga heuristik praktis (hal. 159) yang berfungsi sebagai titik awal yang solid. Berdasarkan pengalaman pemrosesan sinyal, saya menyarankan pedoman berikut:
- Jika jaringan memiliki satu node output dan pemaparan relatif sederhana, tetapkan dimensi tersembunyi ke dua-tiga dari dimensi input.
- Jika ada beberapa output atau hubungan kompleks, gunakan ukuran tersembunyi sama dengan jumlah dimensi input dan output—jaga agar di bawah dua kali ukuran input.
- Untuk pemetaan yang sangat rumit, tetapkan ukuran tersembunyi ke satu kurang dari dua kali dimensi input.
Kesimpulan
Dengan mengikuti prinsip-prinsip ini, Anda dapat secara sistematis mengonfigurasi dan menyempurnakan lapisan tersembunyi dari Perceptron Lapisan Ganda untuk mencapai performa yang kuat. Dalam artikel berikutnya kami akan mendemonstrasikan bagaimana aturan ini diterjemahkan ke dalam kode Python konkret dan mengevaluasi dampaknya pada dataset dunia nyata.



