Mempercepat Deep Learning dengan FPGA: Kecepatan, Fleksibilitas, dan Efisiensi Energi
Mempercepat Deep Learning dengan FPGA: Kecepatan, Fleksibilitas, dan Efisiensi Energi
Saya baru-baru ini menghadiri Forum Pengembang Xilinx 2018 di Silicon Valley, tempat saya menemukan Mipsology, startup yang klaim telah menyelesaikan tantangan terkait AI dalam menyebarkan jaringan saraf pada gate array yang dapat diprogram (FPGA). Dibangun dengan visi berani, Mipsology menunjukkan bagaimana FPGA dapat mempercepat jaringan saraf apa pun hingga performa tertinggi yang mungkin, tanpa dibatasi oleh keterbatasan penerapan tradisional.
Menggunakan papan Alveo baru Xilinx, Mipsology mencapai lebih dari 20.000 gambar per detik di seluruh rangkaian jaringan populer, termasuk ResNet-50, Inception-V3, dan VGG-19.
Apa Itu Jaringan Saraf dan Deep Learning?
Jaringan saraf, terinspirasi oleh jaringan neuron otak manusia, membentuk tulang punggung pembelajaran dalam (DL). DL adalah kerangka matematika yang belajar untuk melakukan tugas secara otonom dengan mengekspos jaringan pada volume data yang besar. Proses melatih jaringan saraf—menyajikannya dengan jutaan sampel yang diberi label—diikuti oleh inferensi, di mana model yang telah dilatih memprediksi hasil untuk data baru.
Misalnya, jaringan pengenalan ucapan mungkin dilatih pada ribuan rekaman suara dan kemudian diterapkan untuk mentranskripsi kata-kata yang diucapkan secara real-time.
Mengapa Inferensi Membutuhkan Performa Ekstrem
Inferensi membutuhkan miliaran atau triliunan penjumlahan dan perkalian per detik—lebih banyak dari pelatihan, yang hanya terjadi sekali. Akibatnya, inferensi adalah pengoreng utama permintaan komputasi dalam sistem AI produksi.
Empat Opsi Hardware untuk Inferensi Pembelajaran Dalam
Insinyur tradisional bergantung pada empat kategori prosesor, menurut urutan dari paling banyak konsumsi daya dan paling tidak fleksibel: CPU → GPU → FPGA → ASIC. Tabel di bawah ini meringkas perbedaan utama.
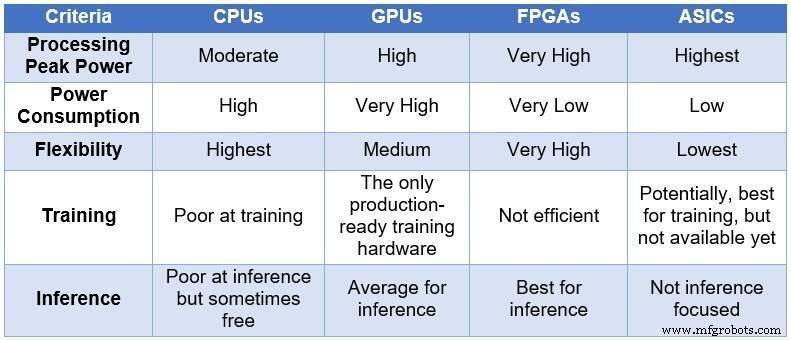
Perbandingan CPU, GPU, FPGA, dan ASIC untuk komputasi DL (Sumber: Lauro Rizzatti)
- CPU menawarkan fleksibilitas maksimum tetapi menderita latensi tinggi dan throughput rendah untuk beban kerja DL.
- GPU menyediakan paralelisme massal tetapi mengonsumsi daya signifikan dan memerlukan pendinginan yang kuat.
- ASIC dapat sangat efisien untuk tugas yang sempit, namun siklus pengembangan yang panjang dan arsitektur tetap membuatnya tidak cocok untuk model yang berkembang dengan cepat.
- FPGA menggabungkan throughput tinggi, konsumsi daya rendah, dan rekonfigurasi, menjadikannya ideal untuk beban kerja inferensi yang dinamis.
Mengapa FPGA Unggul dalam Inferensi
FPGA modern berisi jutaan elemen logika, ribuan blok DSP, dan memori serta inti ARM yang terembed—semua beroperasi secara paralel. Satu siklus jam dapat memicu jutaan operasi bersamaan, mengaktifkan triliunan perhitungan per detik yang secara alami memetakan beban kerja DL.
Keuntungan utama FPGA dibandingkan CPU dan GPU meliputi:
- Dukungan untuk presisi data apa pun, yang memungkinkan aritmatika presisi rendah yang meningkatkan throughput.
- Envelop daya lima sampai sepuluh kali lebih rendah daripada solusi CPU atau GPU yang dapat dibandingkan untuk beban kerja identik.
- Rekonfigurabilitas: perangkat yang sama dapat diperbarui untuk mendukung model baru tanpa memproduksi silikon baru.
- Skalabilitas perangkat: dari kartu data center kelas tinggi hingga modul edge kompak, FPGA cocok untuk berbagai skenario penerapan.
Tantangan dan Trade-Off
Meski memiliki kekuatan, FPGA presents a steep learning curve. Mengembangkan desain berperforma tinggi membutuhkan bahasa deskripsi hardware yang khusus dan pemahaman mendalam tentang paralelisme, yang dapat menjadi hambatan bagi tim yang terbiasa dengan alur kerja yang berpusat pada perangkat lunak.
Nonetheless, untuk organisasi yang menuntut kombinasi kecepatan, fleksibilitas, dan efisiensi energi, FPGA mewakili platform paling menarik untuk inferensi pembelajaran dalam saat ini.



