Downtime Dijelaskan: Penyebab, Dampak, dan Strategi Memaksimalkan Ketersediaan Sistem
Dari laptop dan sabuk konveyor hingga truk tambang dan server flagship Netflix, mesin adalah tulang punggung operasi modern. Setiap periode ketidakaktifan—baik yang diantisipasi atau tidak—mengganggu produktivitas dan merusak kepercayaan pemangku kepentingan.
Di bagian-bagian yang berikut, kami uraikan downtime: definisinya, penyebab akarnya, dan pendekatan praktis untuk mengurangi baik gangguan yang dijadwalkan maupun yang tidak dijadwalkan.
Apa itu Downtime?
Downtime adalah setiap interval di mana sistem atau peralatan tidak tersedia untuk penggunaan yang dimaksudkan.
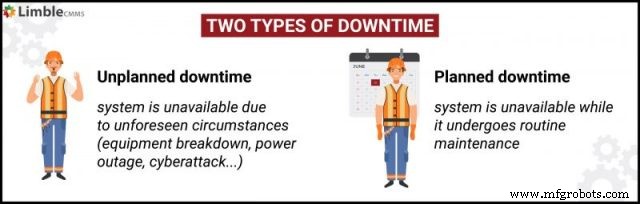
Downtime dapat dijadwalkan—dijadwalkan untuk pemeliharaan, upgrade, atau pemeriksaan—atau tidak dijadwalkan—akibat kegagalan tidak terduga, pemadam listrik, atau insiden siber.
Downtime tidak terduga terjadi ketika peristiwa yang tidak terduga menghentikan operasi. Kegagalan peralatan adalah pemicu paling umum.
Downtime dijadwalkan adalah jeda yang terkontrol yang memungkinkan tim melakukan pemeliharaan rutin, upgrade perangkat lunak, atau pemeriksaan keselamatan.
Terlepas dari niat, downtime berarti aset tidak dapat memenuhi tujuannya selama periode yang dapat diukur.
Di seluruh industri—dari manufaktur berat hingga layanan cloud—downtime berarti pendapatan yang hilang, kontrak yang tertekan, dan kerusakan reputasi.
Downtime dalam Manufaktur
Produsen, terutama yang bergantung pada peralatan intensif aset, telah lama berjuang dengan ketersediaan mesin. Ketika mesin berhenti, baris produksi terhenti, pendapatan menurun, dan mitra rantai pasok mungkin menghadapi keterlambatan.
Indikator kinerja kunci seperti Mean Time To Repair (MTTR) dan Mean Time Between Failure (MTBF) membantu melacak frekuensi dan durasi kegagalan. Meskipun MTTR bukan metrik sempurna, ia menawarkan wawasan berharga ketika dikombinasikan dengan data lain.
Memahami pengemudi utama downtime memungkinkan intervensi yang terfokus, mengurangi baik biaya maupun risiko.
Downtime dalam TI
Dalam TI, downtime adalah interval di mana jaringan, aplikasi, atau server offline. Dampak keuangannya dapat luar biasa—perkiraan industri menetapkan biaya rata-rata pemadaman jaringan sekitar $300.000 per jam.
Penyebab meliputi pemeliharaan dijadwalkan, kegagalan perangkat keras atau lunak, gangguan listrik, dan serangan siber. Bahkan pemadaman singkat dapat menyebabkan kehilangan produktivitas yang signifikan.
Downtime vs. Ketersediaan
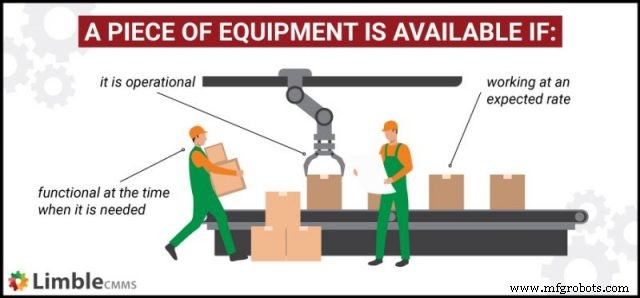
Ketersediaan mengukur probabilitas aset operasional saat dibutuhkan. Ini mencerminkan kemungkinan peralatan akan memberikan output yang diharapkan selama shift yang dijadwalkan.
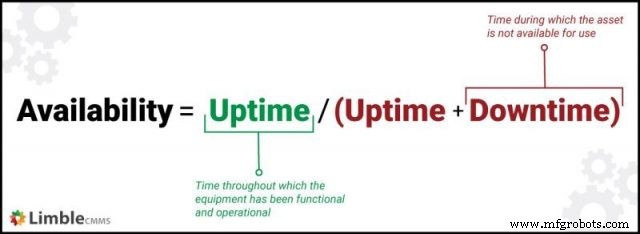
Ketersediaan dihitung dengan membagi waktu operasional dengan jumlah waktu operasional dan downtime:
Angka ketersediaan yang akurat bergantung pada pengukuran downtime yang tepat.
Penyebab Umum Downtime Peralatan
Analisis penyebab akar adalah penting, tetapi banyak peristiwa downtime berasal dari beberapa faktor yang sudah dipahami dengan baik.
Kesalahan Operator
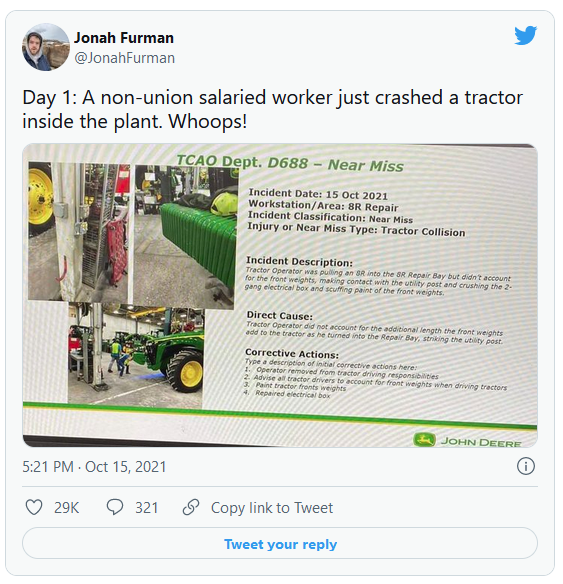
Pelatihan yang tidak memadai atau lingkungan bertekanan tinggi seringkali menyebabkan operator salah menggunakan mesin, yang memicu kerusakan. Misalnya, John Deere baru-baru ini melaporkan penutupan yang disebabkan oleh peralatan yang tidak ditangani dengan benar.
Pemeliharaan Mencegah yang Tidak Cukup
Semua berjalan lancar, tim mungkin mengabaikan pemeriksaan rutin. Tanda peringatan awal—seperti lonjakan getaran atau anomali suhu—seringkali halus dan dapat terlewat tanpa pendekatan sistematis.
Departemen Energi AS memperkirakan bahwa program pemeliharaan pencegah yang kuat dapat:
Mengurangi biaya pemeliharaan hingga 30%.
Mengurangi kegagalan sebesar 35–45%.
Meningkatkan waktu operasional hingga 75%.
Pemeliharaan Berlebih
Melakukan pemadaman atau pemasangans yang tidak perlu menginflasi waktu henti yang dijadwalkan dan memperkenalkan risiko. Setiap jendela pemeliharaan mengekspos peralatan pada potensi kerusakan—dari baut longgar hingga komponen yang tidak rata.
Pemadaman Facebook tahun 2021 mengilustrasikan bagaimana pemeriksaan terjadwal bahkan dapat secara tidak sengaja mengganggu layanan: "Selama penilaian kapasitas rutin, perintah secara tidak sengaja memutuskan semua data center Facebook."
Pemeliharaan berlebih:
Meningkatkan biaya.
Meningkatkan aus dan kerusakan.
Mengkonsumsi jam teknisi yang berharga.
Membuang inventori suku cadang.
Sistem Manajemen Pemeliharaan Berbasis Komputer (CMMS) modern membantu menyeimbangkan frekuensi dengan kebutuhan.
Kurangnya Budaya Keandalan
Di bawah tekanan waktu, tim mungkin kembali ke perbaikan cepat yang melewati prosedur yang tepat. Tanpa budaya yang memprioritaskan keandalan, pintas menjadi norma, yang merusak waktu operasional jangka panjang.
Strategi untuk Mengurangi Downtime yang Dijadwalkan
Meskipun downtime yang dijadwalkan tidak dapat dihindari, durasinya dapat diminimalkan melalui perencanaan yang disiplin.
Standarkan Tugas dan Tingkatkan Pelatihan
Prosedur Operasi Standar (SOP) mengurangi variabilitas antara teknisi. Gabungkan dengan onboarding yang ketat, mereka memastikan setiap anggota kru dapat melakukan tugas secara efisien dan aman.
via GIPHY
Batasi Pemeliharaan Berlebih
Gunakan CMMS seperti Limble untuk memetakan kebutuhan pemeliharaan dengan riwayat aset, ketersediaan teknisi, dan jadwal produksi. Pendekatan berbasis data ini mencegah downtime yang tidak perlu.
Untuk menghilangkan pekerjaan redundan sepenuhnya, investasikan dalam sensor pemantauan kondisi dan analitik pemeliharaan prediktif.
Manfaatkan CMMS untuk Manajemen Downtime
Platform CMMS berbasis cloud mengotomatisasi penjadwalan, pelacakan inventori, dan dokumentasi. Dengan Limble CMMS, Anda dapat membuat pembuat tugas kustom, menyimpan SOP, dan memberikan teknisi akses instan ke log pemeliharaan, panduan troubleshooting, dan daftar periksa keselamatan—semua itu mempercepat turnaround.
Strategi untuk Mengurangi Downtime Tidak Terjadi
Studi oleh Institute of Asset Management menemukan bahwa pabrik kehilangan 5–20% pendapatan mereka karena downtime tidak terduga. Mengurangi insiden ini dapat secara dramatis meningkatkan keuntungan.
Prioritaskan Pemeliharaan Mencegah
Identifikasi peralatan dengan kegagalan tinggi dan buat rencana pemeliharaan yang terfokus. Tindakan proaktif tetap menjadi langkah antisipasi paling efektif.
Sediakan Operasi Kritis dengan Redundansi
Proses kritis mendapat manfaat dari mesin cadangan yang dapat ditukarkan dengan cepat. Meskipun biaya awal lebih tinggi, pengembalian investasi datang dari kesenjangan produksi yang diminimalkan.
Investasikan dalam Peralatan Tahan Kesalahan
Mesin modern yang dirancang dengan toleransi kesalahan bawaan—drive redundan, modul diagnosa sendiri—secara alami mengurangi downtime. Meskipun lebih mahal awalnya, mereka menurunkan biaya pemeliharaan jangka panjang dan risiko downtime.
Buat Protokol Pemeliharaan Darurat
Kegagalan tidak terduga tidak dapat dihilangkan sepenuhnya. Respons darurat yang terstruktur dengan baik—peran yang jelas, komunikasi cepat, dan suku cadang yang disetujui sebelumnya—memastikan pemulihan yang cepat.
Libatkan Operator dalam Pemeliharaan Rutin
Pemeliharaan otonom memberdayakan operator untuk melakukan perawatan dasar, seperti pembersihan, pemeriksaan keselamatan, dan pemeriksaan visual. Manfaatnya meliputi:
Pemilikan peralatan yang ditingkatkan.
Deteksi anomali yang lebih awal.
Beban kerja yang lebih ringan untuk teknisi spesialis.
Secara kolektif, praktik ini menurunkan total downtime dan meningkatkan utilizasi aset.
Tindakan Sekarang Juga
Downtime bukan fenomena pasif—ia membutuhkan manajemen aktif. Baik Anda menangani pemadaman tidak terduga atau mengoptimalkan jendela pemeliharaan yang dijadwalkan, kunci utamanya adalah pengambilan keputusan berbasis data.
Untuk downtime tidak terduga, analisis penyebab akar diikuti oleh tindakan pencegahan sangat penting. Untuk downtime yang dijadwalkan, gunakan CMMS dan analitik prediktif untuk menjadwalkan, mengkoordinasikan, dan mengeksekusi pemeliharaan dengan gangguan minimal.
Limble CMMS menawarkan platform terpadu untuk mengatur semua aktivitas pemeliharaan. Tertarik? Jadwalkan demo atau mulai uji coba gratis hari ini.