Memanfaatkan Document Understanding untuk Mendorong Otomasi, Akurasi, dan ROI
Pemahaman dokumen bertujuan untuk melepaskan data yang terperangkap dalam dokumen untuk memberikan organisasi Anda akurasi data yang jauh lebih tinggi dari data yang diekstrak, produktivitas yang meningkat, dan ROI yang tumbuh dari Otomatisasi Proses Robotik (RPA). Ini terletak di persimpangan pemrosesan dokumen dan kecerdasan buatan (AI) yang bersama-sama berkontribusi pada masa depan di hampir segalanya dapat diotomatisasi.
Ekosistem pemahaman dokumen mencakup teknologi yang dapat menafsirkan informasi dan makna dari berbagai macam tipe dokumen—bahkan tulisan tangan, kotak centang, dan cap. Pembelajaran mesin (ML) memacu inovasi berkelanjutan dalam pemahaman dokumen yang merupakan salah satu area otomatisasi yang tumbuh paling cepat.
Organisasi mungkin sudah bekerja dengan solusi atau penyedia tertentu. Masih, mereka mungkin memerlukan teknologi lain atau keahlian baru untuk memperluas pemahaman dokumen ke fungsi bisnis lain. Sulit untuk menemukan vendor yang memiliki solusi universal yang bekerja dengan semua macam dokumen. Mereka biasanya berfokus pada tipe dokumen atau industri tertentu, seperti asuransi, keuangan, dan perawatan kesehatan. Ada juga vendor yang menawarkan solusi berbasis ML seperti model yang telah dilatih sebelumnya untuk dokumen tertentu. Namun, model-model ini tidak dapat dengan mudah dimodifikasi untuk cocok dengan dokumen di luar domain tersebut.
Saat ini sulit untuk menemukan vendor yang menawarkan solusi universal yang akan bekerja dengan setiap dokumen yang dapat dibayangkan. Sebaliknya, UiPath menawarkan bisnis sebuah cara untuk mengatasi tantangan dan kemungkinan pemrosesan dokumen otomatis. Untuk memulai, ada kemampuan AI bawaan kami yang dapat Anda coba melalui uji coba Enterprise UiPath.
Kemampuan Platform RPA Enterprise UiPath ditingkatkan oleh penawaran mitra yang melengkapi yang memungkinkan pemrosesan dokumen end-to-end yang mulus—yang tersedia di Marketplace UiPath. Marketplace menawarkan ekosistem terbuka dengan solusi mitra yang, digabungkan dengan Platform RPA UiPath, dapat mengatasi berbagai macam kasus penggunaan.
Ayo kita lihat lebih dekat teknologi ekosistem ini dan vendor teratas yang menyediakannya.
Banyak teknologi dapat membuka kekuatan pemahaman dokumen
Ini adalah beberapa teknologi yang paling umum digunakan dalam pemahaman dokumen, bersama mitra UiPath yang membangun solusi di sekitarnya:
Pengakuan karakter optik (OCR)
OCR mengonversi gambar teks yang diketik, ditulis tangan, atau dicetak menjadi teks yang dienkode mesin yang dapat diproses lebih lanjut untuk mengekstrak data yang diinginkan. Teknologi ini biasanya mengekstrak informasi tentang tata letak dan struktur konten juga. Anda mungkin terkadang disendatikan saat bekerja dengan dokumen PDF di mana Anda tidak dapat menyalin teks atau menerapkan pencarian karena halaman PDF pada dasarnya adalah gambar. Sebagian mirip, Anda mungkin memiliki scan, foto, atau tangkapan layar dari terima tagihan, misalnya, dalam format grafis umum seperti JPEG atau TIFF. OCR dapat dengan mudah mengumpulkan semua informasi yang diperlukan dari file-file ini tanpa perlu manusia untuk membaca semua dokumen sendiri.
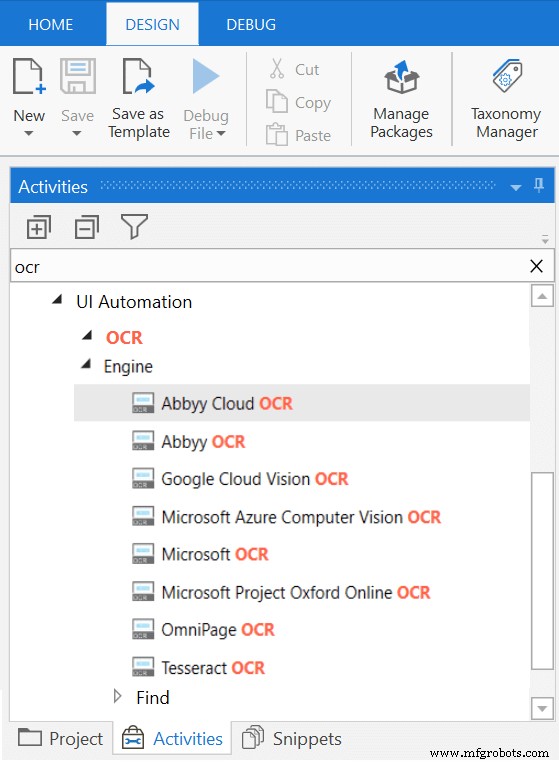
Banyak mesin OCR terbaik di pasar terintegrasi dengan UiPath. Ini termasuk ABBYY FineReader, Tesseract (OCR sumber terbuka yang disediakan oleh Google), Kofax OmniPage, Microsoft OCR, dan Google OCR. Selain itu, UiPath Document OCR baru saja dirilis sebagai pilihan lain yang bagus untuk pelanggan.
Ekstraktor berbasis templat (TBE)
TBE mengekstrak data menggunakan aturan tetap yang diterapkan pada templat yang dibuat oleh pengguna atau mesin. TBE mungkin tidak bekerja untuk dokumen di mana strukturnya berubah dengan sering atau memerlukan variasi templat yang berbeda. Ini berarti bukan opsi saat Anda bekerja dengan banyak organisasi berbeda dan menangani berbagai templat faktur atau terima tagihan yang mereka kirim. Pada saat yang sama, teknologi ini ideal untuk mengelola sejumlah templat yang relatif kecil untuk dokumen stabil. Jangan ragu untuk memilikinya saat Anda memiliki serangkaian templat tetap yang telah ditentukan dan tidak ada pengecualian yang diharapkan. Ketika perubahan format dokumen diperlukan, mudah untuk mengubah templat secara manual.
Ada banyak vendor yang menawarkan TBE. Saat mengevaluasi solusi mana yang akan dipilih, Anda harus memperhatikan seberapa mudah untuk menyiapkan templat, dan bagaimana hasil ekstraksi bergantung pada kualitas gambar. Beberapa perusahaan terbaik menawarkan teknologi yang membuat templat secara semi-otomatis menggunakan proses manusia-dalam-lingkaran yang hanya mengonfirmasi pilihan.
Contoh TBE yang bagus adalah ABBYY FlexiCapture, yang terintegrasi ke dalam UiPath Studio. Ada juga ekstraktor templat UiPath yang tersedia sebagai bagian dari UiPath Document Understanding.
Ekstraktor pembelajaran mesin berbasis pembelajaran terawasi (SMLE)
SMLE dapat digunakan untuk dokumen terstruktur dan semi-terstruktur. Yang terakhir mungkin tidak memiliki tata letak yang ketat seperti dokumen terstruktur tetapi dapat mencakup konten yang serupa. Contoh yang baik adalah faktur dan pesanan pembelian. SMLE bekerja dengan melabeli serangkaian dokumen sampel, yaitu mengaitkan elemen data yang akan diekstrak dengan area dalam dokumen di mana data diekstrak.
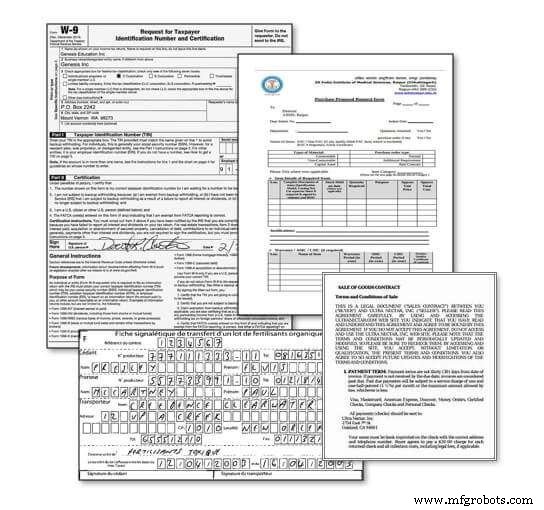
Saat ini, UiPath memiliki ekstraktor berbasis ML untuk faktur, terima tagihan, dan pesanan pembelian. Model yang telah dilatih sebelumnya akan segera tersedia. UiPath juga terintegrasi dengan ABBYY Flexicapture Distributed dan Flexicapture for Invoices yang memanfaatkan model ML yang telah dilatih sebelumnya untuk faktur dan dokumen serupa. Selanjutnya, UiPath terintegrasi dengan Hyperscience, Ephesoft, Vidado, Rossum, Omnius, Microsoft Form Recognizer, dan Amazon Textract. Semua integrasi menawarkan teknik untuk dokumen terstruktur dan semi-terstruktur.
Saat mempertimbangkan opsi SMLE, tanyakan kepada vendor berapa banyak sampel yang diperlukan untuk melatih model. Jika jumlahnya besar, proses ini dapat menimbulkan biaya tinggi karena tugas pelabelan dan kebutuhan akan banyak sampel.
Pembelajaran tidak terawasi (USL)
Teknik ini terdiri dari menganalisis kumpulan data tanpa memerlukan pelabelan data terlebih dahulu. USL memanfaatkan model yang telah dilatih sebelumnya atau representasi pengetahuan yang ramah komputer untuk memproses dokumen tidak terstruktur. Kasus penggunaan umum termasuk menganalisis laporan keuangan, kontrak, dan email.
UiPath memiliki beberapa mitra yang menawarkan solusi USL, termasuk Indico, SortSpoke, Botminds AI Technologies, dan Xtracta. Indico, misalnya, menawarkan alat pelabelan yang didukung komputer yang menyarankan label yang terkait dengan data dalam dokumen. Yang perlu dilakukan pengguna hanyalah menyetujuti atau menimpa mereka.
Pemrosesan bahasa alami (NLP)
Teknologi NLP membantu komputer memahami bahasa manusia. NLP sering digabungkan dengan teknologi lain untuk melakukan berbagai tugas. Ini memungkinkan organisasi untuk mengeksekusi analisis teks, ekstraksi entitas, dan mengotomatisasi proses dengan mendefinisikan niat dalam dokumen tidak terstruktur seperti email. Jika Anda ingin mengekstrak Tanggal Mulai dan Tanggal Selesai dari dokumen tidak terstruktur, Anda harus dapat memetakan garis waktu kerja karena banyak tanggal adalah sinonim. NLP membantu Anda melakukan ini karena dapat menentukan dan menganalisis sinonim. Selain itu, mungkin menganalisis sentimen teks—dengan kata lain, menentukan apakah positif, negatif, atau netral. Ini mungkin sangat berharga untuk menafsirkan konten dalam berita, media sosial, atau korespondensi. Mitra dan teknologi NLP yang terintegrasi dengan UiPath termasuk Expert System, Amazon Comprehend, dan Stanford NLP Group.
Alternatif baru—outsourcing proses bisnis dan manusia dalam lingkaran
Beserta teknologi dan perusahaan terkemuka yang tercantum di atas, terdapat munculnya vendor yang menawarkan outsourcing proses bisnis (BPO) dan proses manusia dalam lingkaran (HITL) untuk meningkatkan pemahaman dokumen.
Misalnya, Ocrolus dan Contract Wrangler memiliki teknologi berbasis ML yang kuat untuk pemahaman dokumen. Namun, mereka melibatkan tenaga kerja crowdsourced manusia yang membantu memperbaiki hasil ekstraksi dokumen yang tidak memenuhi ambang akurasi yang diinginkan. Kedua perusahaan ini mengganggu karena mereka menjamin akurasi hingga 99,99% dan komitmen waktu untuk pengiriman. Tentu saja, akurasi yang lebih tinggi dan persyaratan waktu yang lebih pendek mungkin menimbulkan biaya yang lebih tinggi untuk pelanggan.
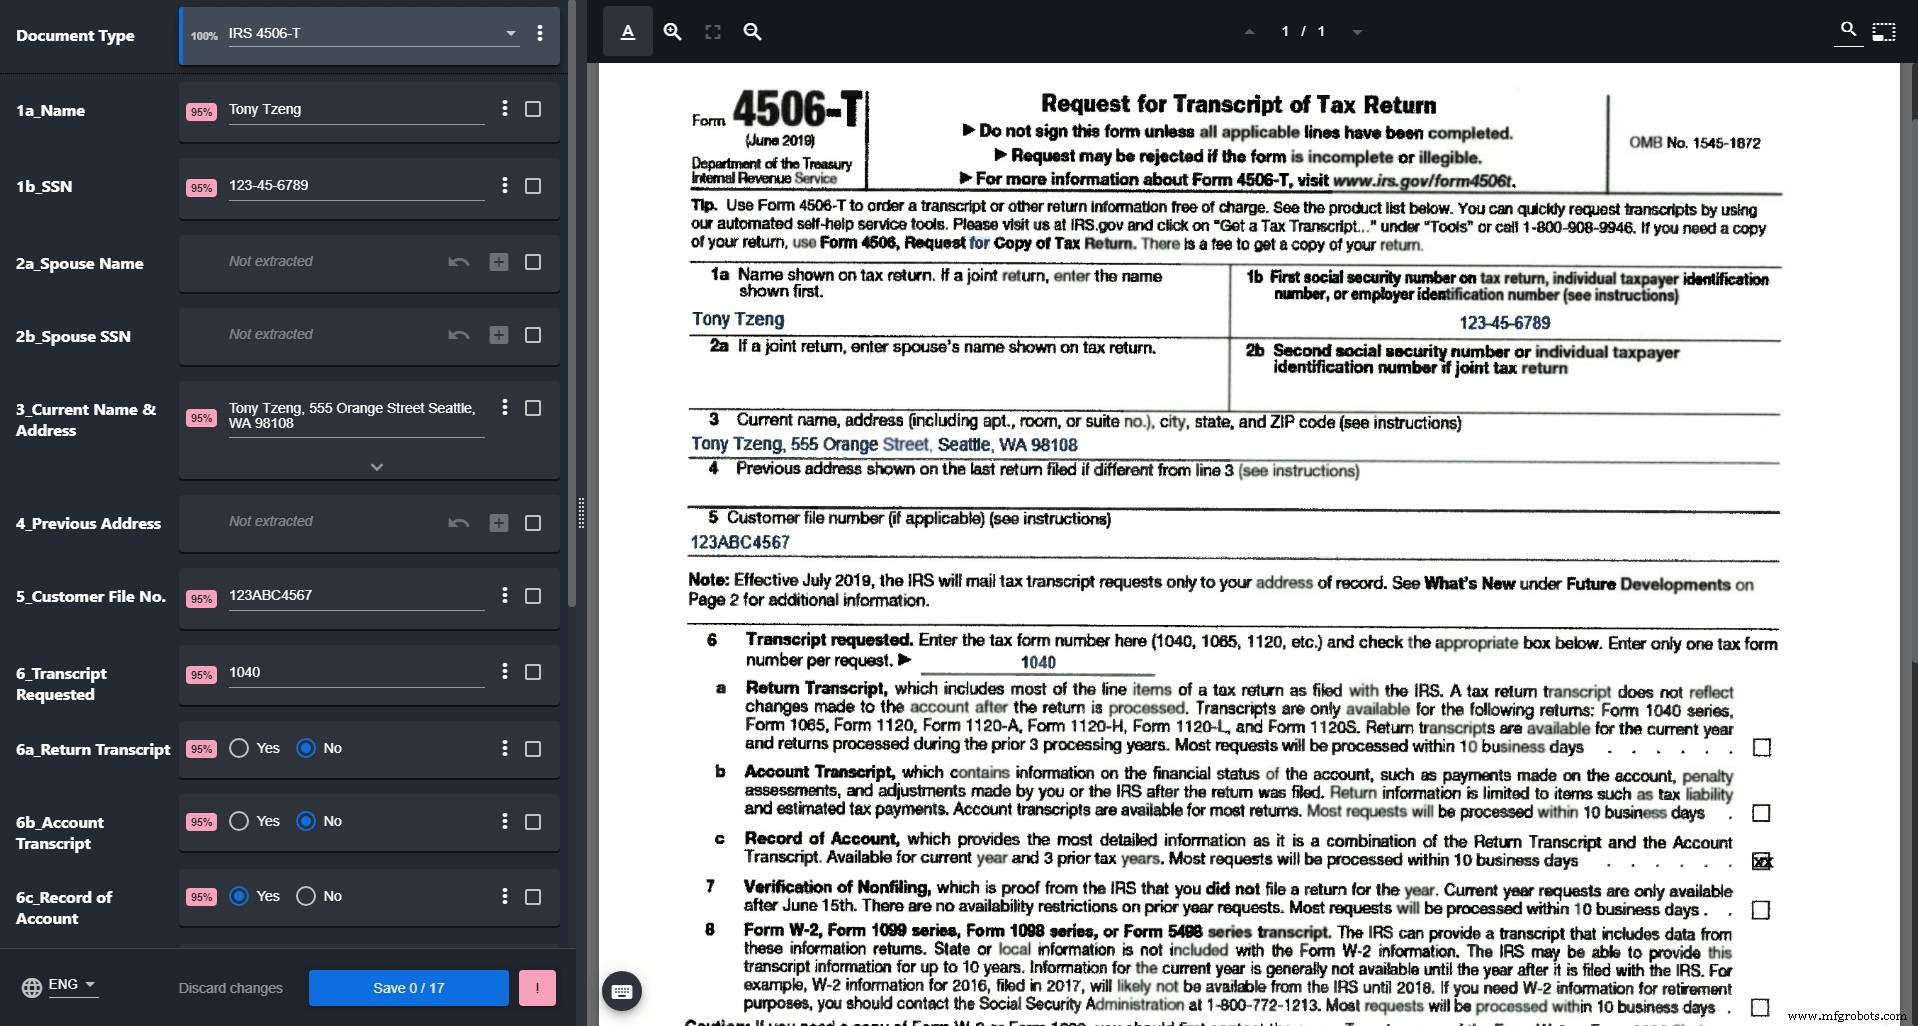
Selain itu, solusi UiPath Document Understanding menyediakan Validation Station. Alat ini memungkinkan pengguna untuk meninjau dan, jika diperlukan, memperbaiki hasil klasifikasi dokumen dan ekstraksi data otomatis.
Pikiran akhir tentang memilih solusi
Memilih solusi yang memenuhi semua kebutuhan bisnis Anda untuk pemahaman dokumen dapat menimbulkan tantangan besar. Biasanya ini mengarah pada evaluasi opsi untuk menerapkan beberapa solusi secara bersamaan dan mencari cara terbaik untuk mengintegrasikannya. Itulah sebabnya UiPath bekerja dan terintegrasi dengan berbagai macam vendor terkemuka industri. Kami telah mendirikan ekosistem pemahaman dokumen yang kaya yang melengkapi Platform RPA UiPath.
Untuk informasi yang lebih mendalam, bergabunglah dalam webinar kami "Product Spotlight: AI-Enhanced Automations – Combining Transformative Capabilities". Anda akan melihat bagaimana UiPath Document Understanding dan solusi berbasis ML lainnya dapat membantu membawa otomatisasi Anda ke tingkat yang sepenuhnya baru—didukung oleh AI. Anda juga dapat mencoba kemampuan ini untuk membantu mengotomatisasi proses bisnis Anda dengan mendaftar untuk uji coba Enterprise UiPath.



