Skala AI untuk Keuntungan Bisnis Nyata: Strategi Terbukti untuk Sukses Operasional
Kecerdasan buatan (AI) sedang memberdayakan norma baru untuk bisnis di seluruh industri. Peritel, misalnya, dapat menggunakan AI untuk memprediksi pesanan pembelian berdasarkan data persediaan historis untuk mendorong keputusan restocking yang cerdas. Tim dukungan pelanggan dapat menggunakan AI untuk secara otomatis merespons dan merute tiket dukungan pelanggan prioritas tinggi ke tim yang tepat. Ada dunia kemungkinan di mana Anda dapat menggunakan AI, dan khususnya ML, untuk mendorong hasil bisnis praktis.
Menurut Deloitte Insights, 83% adopsi awal AI perusahaan melihat return on investment (ROI) positif dari proyek dalam produksi. Ini termasuk contoh seperti penerapan perangkat lunak enterprise pihak ketiga menggunakan AI, penggunaan chatbot dan asisten virtual, dan mesin rekomendasi untuk platform e-commerce. Delapan puluh tiga persen perusahaan yang disurvei berencana untuk meningkatkan pengeluaran pada AI pada 2019. Dari perusahaan yang berinvestasi pada AI, 63% telah mengadopsi ML.
Membangun strategi untuk menggunakan AI dan ML secara pragmatis untuk mencapai tujuan bisnis adalah prioritas utama bagi banyak perusahaan. Untuk banyak, tantangan utama untuk berhasil mengoperasionalkan ML adalah memahami, merencanakan, dan mengeksekusi manajemen penerapan ML yang menyeluruh di seluruh organisasi.
Pertimbangan teratas untuk mengoperasionalkan ML
Cara yang “benar” untuk menangani siklus hidup data science berbeda dari satu organisasi ke organisasi lain. Banyak upaya telah dilakukan untuk mengkodekan dan menyelaraskan prosedur siklus hidup data science. Namun, tidak ada pendekatan manapun yang mencakup kebutuhan setiap perusahaan.
Menerima strategi yang berkelanjutan dan dapat dipelihara untuk data dan data science adalah latihan yang terus berkembang yang berbeda untuk setiap perusahaan. Karena kebutuhan, struktur, dan kemampuan setiap perusahaan unik, pemangku kepentingan dari seluruh perusahaan harus dikonsultasi untuk membangun model ML yang fleksibel dan dapat diskala dan mengeksekusi strategi data science yang menyeluruh.
Tantangan operasional dan perubahan pada infrastruktur serta praktik pengembangan yang harus diatasi oleh setiap perusahaan akan berbeda.
Kritis bagi organisasi Anda untuk mempertimbangkan budaya, sistem, dan kebutuhan saat Anda saat menentukan dan mengembangkan siklus hidup data science. Memiliki kerangka dasar untuk disajikan di seluruh tim membantu mengembangkan dasar komunikasi yang umum saat Anda terus mengembangkan dan mengembangkan pengoperasianan ML Anda.
Mari kita melalui kerangka kerja standar yang dapat membantu organisasi Anda memulai perjalanan ML.
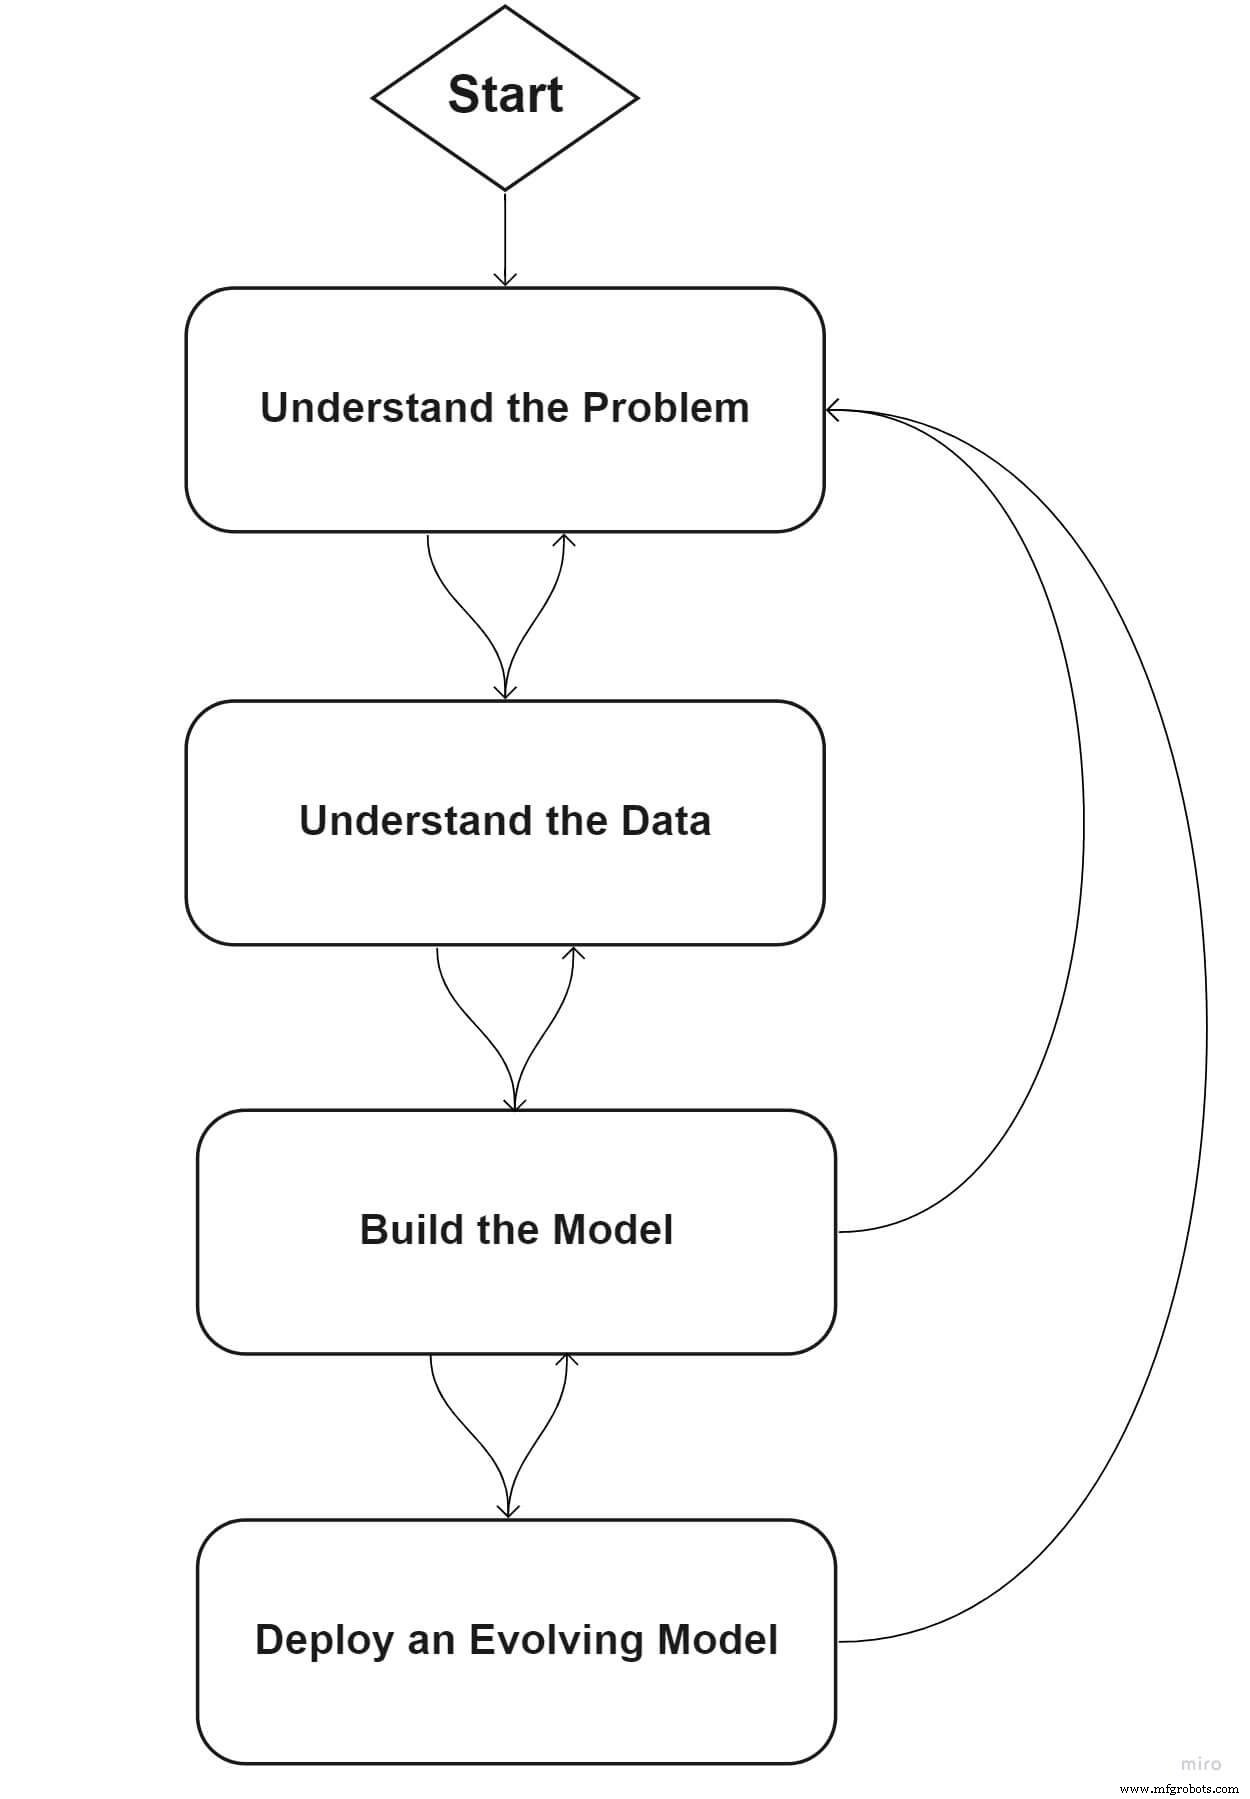
Fase satu: Definisikan masalah Anda
Di inti setiap inisiasi ML ada dua pertanyaan:
1. Masalah apa yang ingin Anda selesaikan?
2. Mengapa Anda percaya ML dan pemahaman yang lebih baik tentang data Anda dapat membantu Anda menyelesaikan masalah yang Anda hadapi?
Jawaban untuk pertanyaan ini tergantung pada bagaimana perusahaan Anda memikirkan strategi dan mengevaluasi masalah bisnis.
Selama fase satu, pemangku kepentingan utama harus berkumpul untuk menentukan cakupan awal masalah dan persyaratannya.
Fase dua: Pahami data Anda
Apa cerita data Anda? Dari mana data Anda berasal, dan berapa banyak sumber data yang relevan untuk membantu Anda menyelesaikan masalah bisnis spesifik Anda?
Selama fase ini, perusahaan berfokus pada:
Memetakan sumber data yang relevan dan lingkungan tempat mereka berada (lingkungan semacam itu mungkin berada di on-premises atau di cloud, diatur sebagai gudang data, data lake, atau platform data streaming)
Menentukan pipeline data mana yang saat ini ada, dan pipeline data mana yang perlu dibangun untuk validasi data, pembersihan, dan eksplorasi
Memahami seberapa sering data diperbarui
Memahami kepercayaan data
Mengevaluasi pertimbangan dan persyaratan privasi data
Mengaktifkan eksplorasi data melalui visualisasi, properti statistik data mentah dan yang ditransformasi, dll.
Memahami data Anda bukanlah tugas yang kecil. Penting untuk mendekati fase ini secara iteratif. Saat Anda menemukan lebih banyak tentang data Anda, Anda mungkin menemukan masalah yang mempengaruhi kemampuan Anda untuk menyelesaikan masalah yang mungkin lebih lanjut meminta Anda untuk menentukan ulang atau mengubah cakupan masalah dari fase satu.
Fase tiga: Bangun model ML
Setelah data Anda siap, saatnya bagi data scientist Anda untuk membangun model ML. Langkah-langkah umum untuk membangun model ML yang kuat meliputi:
Mengekstrak dan merangka fitur (termasuk binning, data whitening, dan menerapkan transformasi statistik)
Memilih fitur
Melatih model (termasuk membagi data menjadi sejumlah data pelatihan, cross-validation, dan validasi)
Menyesuaikan hyperparameter
Mengevaluasi model
Memvalidasi signifikansi statistik
Mengembangkan model memerlukan umpan balik yang berkelanjutan dari pemangku kepentingan bisnis. Misalnya, masalah bisnis mungkin memerlukan affinensi terhadap sensitivitas terhadap spesifikitas. Anda mungkin sama menukarkan sedikit performa prediktif (misalnya, skor F1) untuk performa operasional model (misalnya, prediksi lebih cepat), atau penjelasan model.
Tujuan data scientist adalah untuk membangun model yang menggunakan data untuk menceritakan cerita yang jelas terkait masalah bisnis. Saat masalah berkembang dan persyaratan berubah, pendekatan pemodelan juga harus berevolusi untuk melayani konteks saat ini.
Fase empat: Terapkan model yang berevolusi
Membangun model awal hanyalah awal dari perjalanan ML. Menerapkan model yang berevolusi adalah langkah krusial untuk penciptaan nilai jangka panjang bagi organisasi.
Menerapkan model yang berevolusi memerlukan:
Menyajikan model (membuat model sangat tersedia dan dapat diskala secara horizontal)
Mengelola versi model (termasuk rollback dan deployment canary/challenger)
Melatih ulang model (memodifikasi atau membangun model baru saat data baru masuk ke sistem)
Memantau model (melacak metrik operasional dan pengalaman pengguna pada waktu pelayanan dan pelatihan)
Memantau drift data dan model, memerlukan spesialisasi model untuk kasus penggunaan intra-organisasi yang ditargetkan, dan memelihara pipeline data (di antara item pemeliharaan lainnya) adalah krusial untuk keberlanjutan model.
Persyaratan perusahaan dan industri dapat berevolusi dengan cepat dan mempengaruhi sumber dan input data. Misalnya, tata kelola dan kepatuhan dalam skala adalah pertimbangan yang melingkupi seluruh siklus hidup data science.
Kepatuhan terhadap regulasi—seperti General Data Protection Regulation (GDPR) Uni Eropa (UE)—memerlukan tingkat pelacakan yang lebih dalam pada lapisan versi data, versi model, dan input model. Membangun strategi untuk merespons perubahan dan persyaratan industri ini melalui data dapat membantu perusahaan terus memanfaatkan ML untuk mendorong hasil bisnis yang lebih baik seperti pertumbuhan pendapatan, pengurangan biaya, dan penurunan risiko.
Apa selanjutnya?
Mengoperasionalkan ML secara fleksibel, dapat dipelihara, dan dapat diskala memerlukan banyak langkah dan pertimbangan di luar cakupan tingkat tinggi yang telah kami gariskan dalam blog ini. Iblis ada dalam detail.
Dalam blog berikutnya kami, kami akan menyelami lebih dalam ke dalam pertimbangan teknis, tantangan yang dapat timbul dari implementasi ad-hoc dari sistem ML skala besar, dan bagaimana UiPath membantu mengatasi tantangan umum bagi pelanggan perusahaan.



